Pengujian Data: Menimbang Etika, Keterbukaan, dan Ketangguhan Data Penelitian Biologi
E-Modul Pertemuan 10 · Teknologi Informasi dan Literasi Data (TILDA)
Ketika Data Diuji
Menimbang Etika, Keterbukaan, dan Ketangguhan Data Penelitian Biologi
Dari Penghafal Aturan Menjadi Juri
Bayangkan Anda sudah hafal seluruh aturan sepak bola, dari ukuran lapangan sampai definisi offside. Hafalan itu berguna, tetapi belum membuat Anda layak memimpin pertandingan. Wasit yang baik harus bisa melihat kejadian yang berlangsung cepat, menimbang niat pemain, lalu memutuskan pelanggaran atau bukan dalam hitungan detik. Pertemuan 9 memberi Anda buku aturannya, dan pertemuan 10 ini melatih Anda meniup peluit. Itulah sebabnya kata kerja pada indikator kita berubah dari menjelaskan menjadi mengevaluasi.
Mengevaluasi berarti memberi penilaian yang disertai alasan, bukan sekadar menyebut benar atau salah. Seorang evaluator bertanya apa yang terjadi, prinsip apa yang dipertaruhkan, siapa yang dirugikan, dan langkah apa yang paling masuk akal untuk memperbaikinya. Dalam penelitian biologi, pertanyaan semacam ini muncul setiap hari, dari cara mencatat data lapangan sampai keputusan membagikan koordinat spesies langka. Kabar baiknya, keterampilan menilai ini bisa dilatih, dan bahan latihannya tersedia melimpah dalam bentuk kasus nyata. Modul ini mengumpulkan kasus-kasus tersebut dari jurnal ilmiah terkemuka, lalu mengubahnya menjadi alat yang bisa Anda pakai sendiri.
Studi Kasus Mini · Rina dan Tabel yang Terlalu RapiKisah rekaan untuk ilustrasi
Rina, mahasiswa semester tiga, sedang membantu kakak tingkatnya merapikan data pengukuran panjang daun dari tiga lokasi di kaki Gunung Sibayak. Ia heran karena kolom lokasi kedua berisi angka yang nyaris identik, baris demi baris, seolah disalin. Kakak tingkatnya berkata santai bahwa sebagian data memang “ditambal” karena hujan membuat pengukuran tertunda, dan toh hasilnya tidak akan jauh berbeda. Rina ragu, tetapi ia juga tidak ingin merusak hubungan baik dengan seniornya. Di titik inilah seorang peneliti muda diuji, bukan oleh soal ujian, melainkan oleh keputusan kecil yang tidak dilihat siapa pun.
Apa yang sebaiknya Rina lakukan? Simpan dulu jawaban Anda. Kita akan kembali ke Rina di Pojok Refleksi, setelah Anda punya alat untuk menilainya.
“Aturan membuat kita tahu batasnya. Evaluasi membuat kita berani menjaganya.”
Poin Penting
- Pertemuan 9 berfokus pada memahami prinsip etika dan keamanan data. Pertemuan 10 berfokus pada menilai penerapannya dalam kasus nyata.
- Evaluasi yang baik selalu memuat tiga unsur: penilaian, alasan, dan rekomendasi.
- Lima topik modul ini: evaluasi kasus etika, Open Science, Responsible AI, ketangguhan data, dan praktik terbaik pengelolaan data.
Menimbang Kasus: Dari Kekeliruan Jujur sampai Pemalsuan
1.1 Seberapa sering sebenarnya?
Banyak orang membayangkan pemalsuan data sebagai ulah segelintir oknum, semacam apel busuk dalam keranjang yang sehat. Fanelli (2009) menguji anggapan itu dengan menggabungkan hasil 21 survei yang menanyai ilmuwan secara langsung, dan 18 di antaranya dianalisis dalam meta-analisis. Hasilnya, rata-rata tertimbang 1,97% ilmuwan mengaku pernah memfabrikasi, memfalsifikasi, atau memodifikasi data setidaknya sekali. Ketika pertanyaannya diganti menjadi apakah mereka pernah mengetahui rekan melakukannya, angkanya melonjak menjadi 14,12%. Untuk praktik penelitian yang meragukan, pengakuan diri mencapai 33,7% dan kesaksian terhadap rekan bahkan sampai 72%.
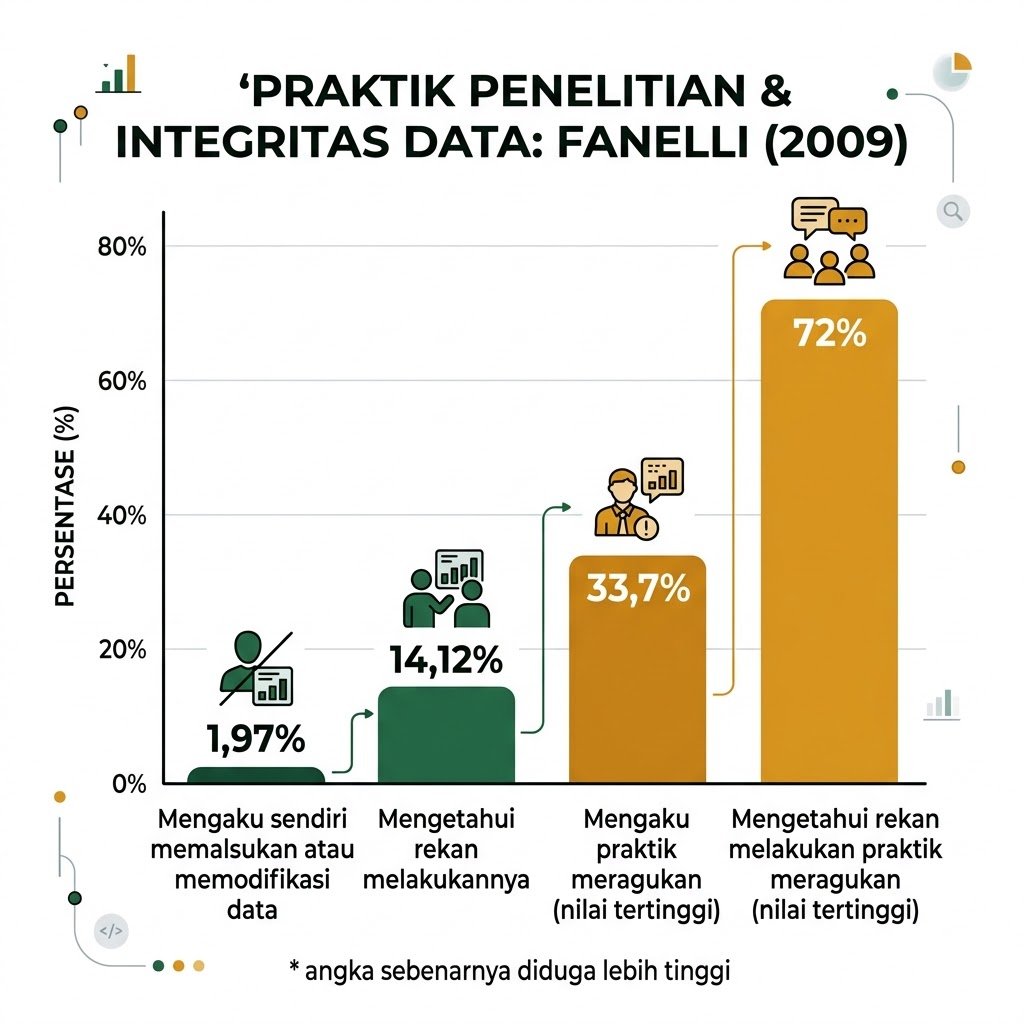
Mengapa angka pengakuan diri jauh lebih kecil daripada angka kesaksian? Fanelli menduga ada efek yang ia sebut efek Mohammed Ali, yaitu kecenderungan orang menilai dirinya lebih jujur daripada rekan-rekannya. Selain itu, reputasi kejujuran adalah modal utama seorang ilmuwan, sehingga siapa pun yang pernah memalsukan data cenderung enggan mengakuinya, bahkan dalam survei anonim. Karena itu Fanelli menyimpulkan bahwa angka-angka tadi kemungkinan besar masih lebih rendah daripada kenyataannya. Pesannya untuk kita sederhana: pelanggaran integritas bukan peristiwa langka yang hanya terjadi di negeri yang jauh.
1.2 Kekeliruan, wilayah abu-abu, dan pemalsuan
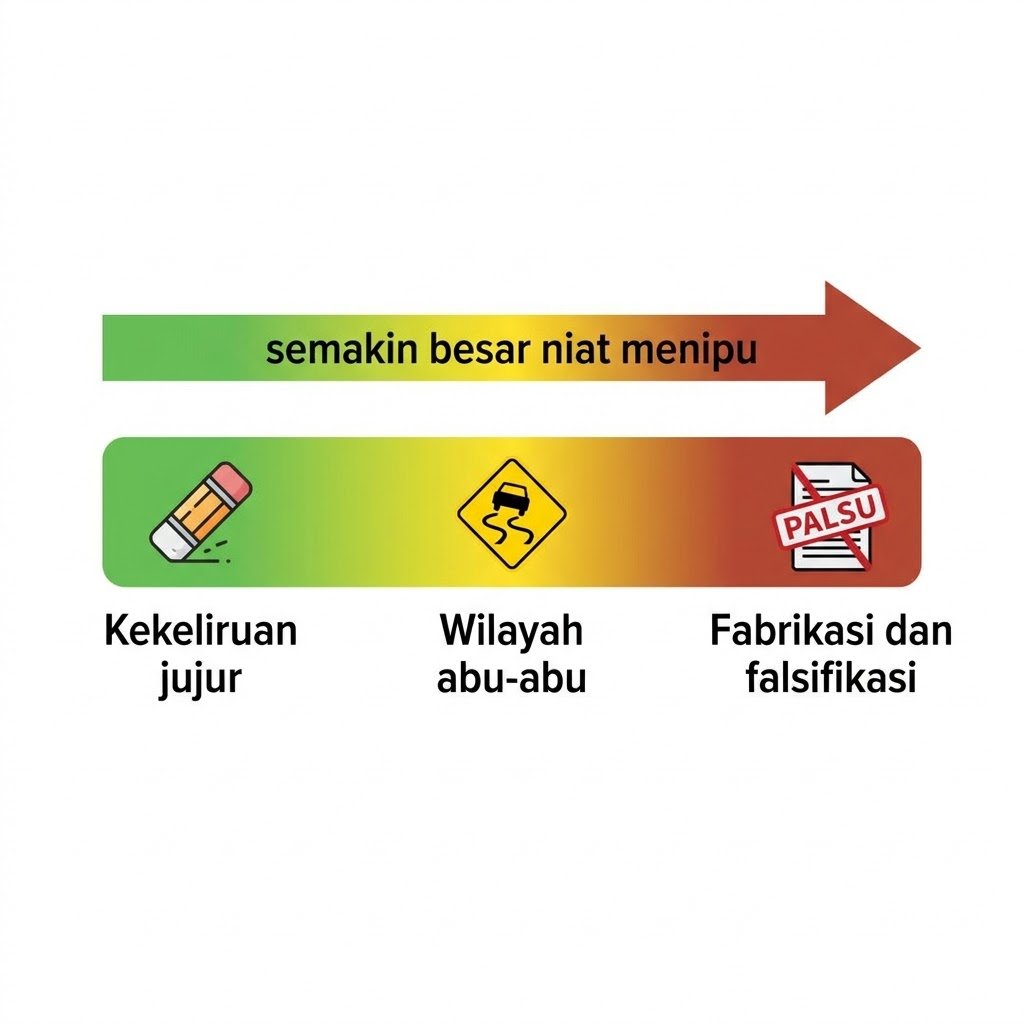
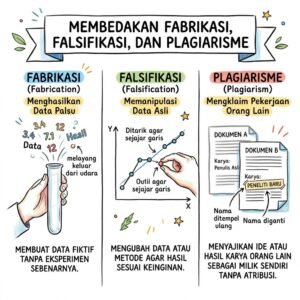
Tidak semua data yang salah lahir dari niat jahat. Fanelli menegaskan bahwa unsur kunci pelanggaran berat adalah niat untuk menipu, sedangkan kekeliruan yang tidak disengaja atau perbedaan tafsir yang jujur tidak digolongkan sebagai pelanggaran. Di antara dua kutub itu terbentang wilayah abu-abu yang disebut praktik penelitian meragukan, misalnya membuang titik data hanya berdasarkan firasat. Wilayah abu-abu inilah yang paling licin, karena pelakunya sering merasa sedang merapikan data, bukan membengkokkannya. Bayangkan sebuah jalan menurun tanpa pagar: orang jarang jatuh karena melompat, tetapi karena tergelincir sedikit demi sedikit.
| Aspek | Kekeliruan jujur | Praktik meragukan | Fabrikasi dan falsifikasi |
|---|---|---|---|
| Niat | Tidak ada niat menipu | Samar; sering dirasionalisasi | Sengaja mengarang atau membelokkan data |
| Contoh biologi | Salah ketik satuan berat spesimen; label foto gel tertukar | Membuang individu “aneh” tanpa kriteria yang ditetapkan sebelumnya; hanya melaporkan hasil yang signifikan | Mengisi data pengamatan yang tidak pernah dilakukan; menyalin gambar untuk perlakuan berbeda |
| Respons yang proporsional | Koreksi terbuka (erratum), perbaikan prosedur | Transparansi penuh, pelaporan alasan, diskusi dengan pembimbing | Penarikan publikasi (retraksi) dan pemeriksaan oleh lembaga |
1.3 Jejak yang bisa dilihat mata
Kalau pemalsuan sulit diakui, bisakah ia dideteksi? Bik dkk. (2016) memeriksa gambar dari 20.621 makalah di 40 jurnal yang terbit antara 1995 dan 2014, terutama gambar western blot, pita gel, dan foto mikroskop. Mereka menemukan 782 makalah atau 3,8% memuat duplikasi gambar yang tidak semestinya, dan setidaknya separuhnya menunjukkan ciri manipulasi yang disengaja. Menariknya, semua itu ditemukan melalui pengamatan visual, tanpa perangkat lunak forensik khusus. Artinya, mata yang terlatih dan kebiasaan memeriksa ulang sudah merupakan alat audit yang sangat kuat.
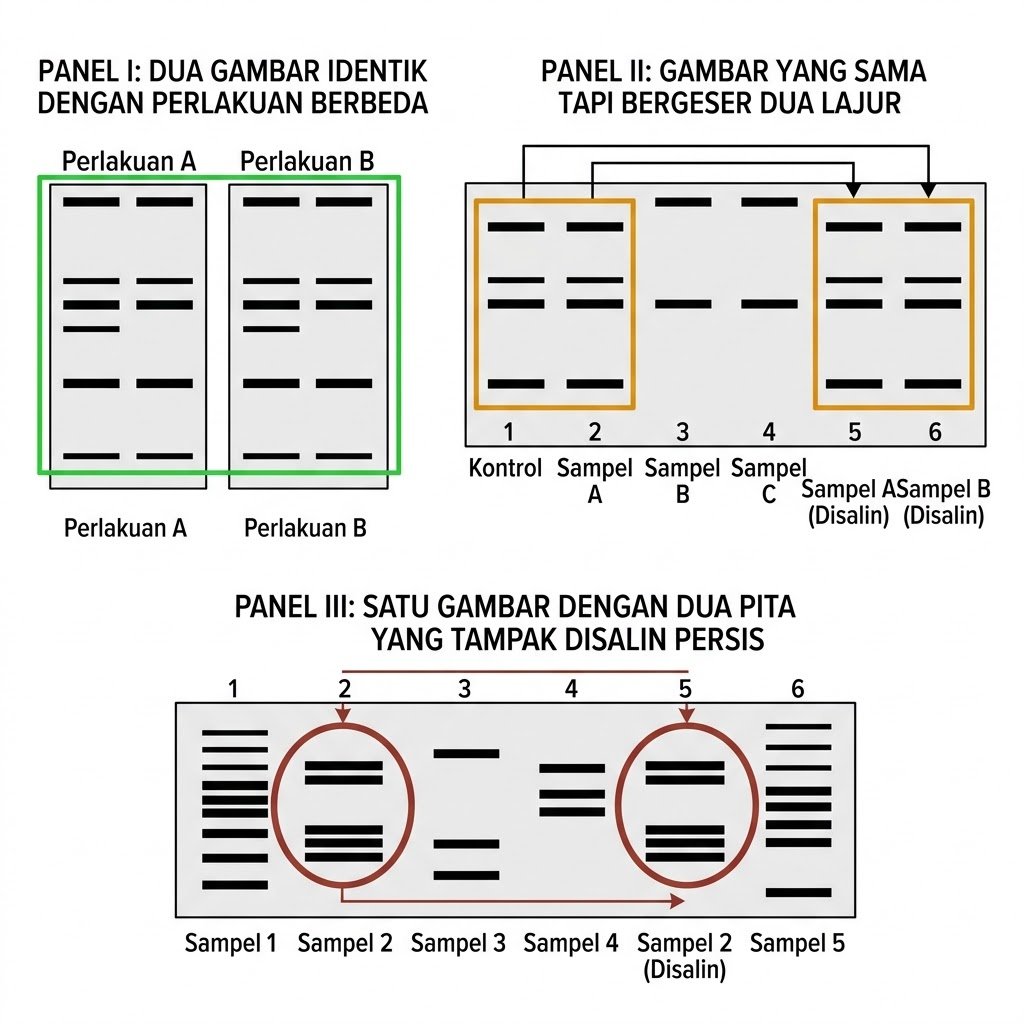
Bik dan rekan membagi temuan mereka ke dalam tiga kategori yang bertingkat. Kategori pertama adalah duplikasi sederhana, yaitu gambar yang sama dipakai untuk dua kondisi percobaan berbeda, dan ini paling mungkin muncul dari kecerobohan saat menyusun figur. Kategori kedua adalah duplikasi dengan reposisi, ketika gambar yang sama digeser, diputar, atau dibalik. Kategori ketiga adalah duplikasi dengan alterasi, misalnya pita gel yang disalin berulang atau area gambar yang ditambal. Semakin tinggi kategorinya, semakin besar usaha sadar yang dibutuhkan, sehingga semakin sulit pula menyebutnya sebagai ketidaksengajaan.
| Kategori | Wujudnya | Jumlah makalah | Kemungkinan penyebab |
|---|---|---|---|
| I. Duplikasi sederhana | Panel identik mewakili kondisi berbeda | 230 (29,4%) | Paling mungkin kecerobohan, tetapi bisa juga disengaja |
| II. Duplikasi dengan reposisi | Gambar sama yang digeser, diputar, atau dibalik | 356 (45,5%) | Lebih mungkin disengaja |
| III. Duplikasi dengan alterasi | Pita, sel, atau area yang disalin dan ditambal | 196 (25,1%) | Lebih mungkin disengaja |
Sumber: diolah dari Bik dkk. (2016), total 782 makalah bermasalah.
Temuan lain yang patut direnungkan adalah pola berulang. Ketika Bik dan rekan memeriksa makalah lain dari penulis pertama atau terakhir yang makalahnya bermasalah, 38,8% di antaranya ternyata memiliki setidaknya satu makalah lain yang juga bermasalah. Masalah dalam penyusunan figur rupanya cenderung menjadi kebiasaan, bukan kejadian sekali lewat. Sebaliknya, jurnal yang rutin memeriksa gambar sebelum terbit, seperti Journal of Cell Biology, hanya memuat 0,3% makalah bermasalah. Pelajarannya jelas: kebiasaan baik dan pemeriksaan berlapis lebih efektif daripada sekadar berharap semua orang jujur.
Studi Kasus Mini · Laba-Laba, Kepribadian, dan Data yang BerulangKasus nyata, berdasarkan laporan Pennisi (2020) di jurnal Science
Jonathan Pruitt pernah menjadi bintang muda ekologi perilaku berkat temuannya tentang kepribadian laba-laba sosial, ada yang pemalu dan ada yang agresif. Pada 2018 ia menerima Canada 150 Research Chair yang bergengsi di McMaster University. Keadaan berbalik ketika seorang peneliti muda mempertanyakan data dalam salah satu makalahnya di The American Naturalist, lalu tim yang memeriksanya menemukan terlalu banyak titik data yang berulang persis sama. Kate Laskowski, rekan penulisnya, kemudian menemukan kejanggalan serupa di makalah lain yang datanya juga hanya berasal dari Pruitt. Dalam sekitar dua minggu, dua makalah sudah ditarik dan sebanyak 23 jurnal mulai mengevaluasi makalah-makalah yang melibatkannya.
Pruitt menyatakan tidak melakukan penipuan dan menyebut masalah itu sebagai kesalahan pengelolaan data. Namun para koleganya kini harus melakukan pekerjaan forensik yang tidak pernah mereka bayangkan, misalnya memeriksa deretan angka yang tidak seacak seharusnya. Noa Pinter-Wollman, yang menulis hampir 20 makalah bersama Pruitt, menyebut situasi ini sebagai tragedi karena ia kehilangan kolaborator yang dipercayainya. Kasus ini memperlihatkan bahwa satu sumber data yang tidak diawasi bisa mengguncang karya banyak orang yang bekerja dengan jujur. Perhatikan pula bahwa ketika laporan ini ditulis, statusnya masih berupa dugaan yang sedang diperiksa, sehingga penilaian kita harus tetap berpijak pada bukti.
Diskusikan: bagian mana dari kasus ini yang merupakan fakta, dan bagian mana yang masih berupa dugaan? Pelajaran apa yang bisa dipetik oleh rekan penulis yang tidak pernah memegang data mentah?
1.4 Alat evaluasi Anda: kerangka FAKTA
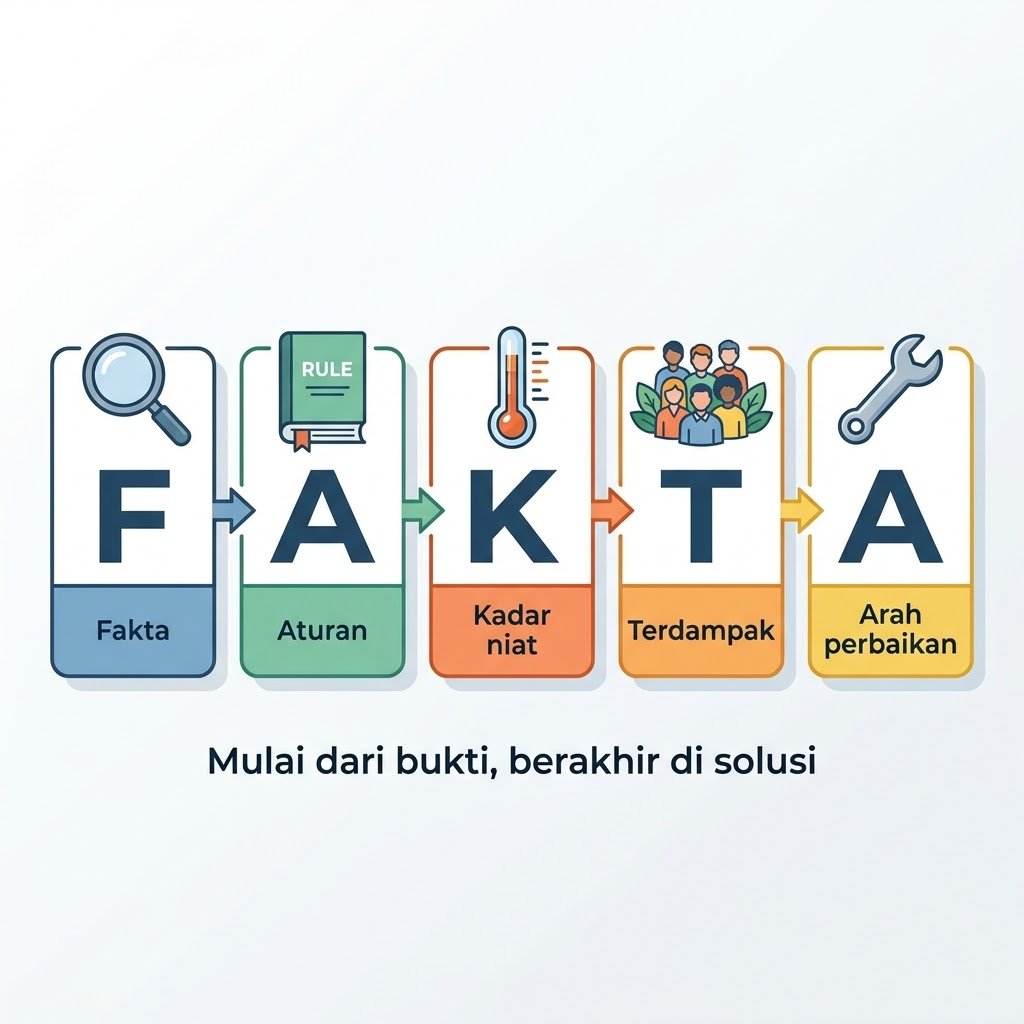
Agar penilaian tidak didorong emosi atau kabar burung, Anda memerlukan urutan berpikir yang konsisten. Modul ini menawarkan kerangka lima langkah bernama FAKTA, yang dirangkum dari gagasan-gagasan dalam literatur di atas. Setiap huruf mewakili satu pertanyaan yang harus dijawab sebelum Anda menjatuhkan penilaian. Urutannya sengaja dimulai dari fakta dan diakhiri dengan solusi, karena vonis tanpa fakta hanyalah gosip, sedangkan fakta tanpa solusi hanyalah keluhan. Gunakan kerangka ini untuk setiap studi kasus dalam diskusi kelompok nanti.
| Langkah | Pertanyaan kunci | Contoh pada kasus Pruitt | |
|---|---|---|---|
| F | Fakta | Apa yang sebenarnya terjadi, dan apa buktinya? | Titik data berulang persis sama di beberapa makalah |
| A | Aturan | Prinsip atau regulasi mana yang dipertaruhkan? | Integritas data (larangan fabrikasi dan falsifikasi) |
| K | Kadar niat | Kekeliruan jujur, praktik meragukan, atau kesengajaan? | Belum dapat dipastikan; perlu investigasi lembaga |
| T | Terdampak | Siapa dan apa yang dirugikan? | Rekan penulis, mahasiswa, jurnal, dan bidang ilmu |
| A | Arah perbaikan | Tindakan korektif dan pencegahan apa yang proporsional? | Retraksi makalah bermasalah, audit data mentah, verifikasi silang |
- Saya sudah memisahkan fakta yang terbukti dari dugaan atau opini.
- Saya sudah menyebut prinsip atau regulasi yang relevan secara spesifik.
- Saya tidak menyimpulkan niat tanpa bukti yang memadai.
- Saya sudah memetakan pihak yang dirugikan, termasuk makhluk hidup dan komunitas.
- Rekomendasi saya bersifat korektif sekaligus mencegah kejadian berulang.
“Vonis tanpa fakta hanyalah gosip, dan fakta tanpa solusi hanyalah keluhan.”
Tips dan Trik
- Nilailah perbuatannya, bukan orangnya. Diskusi yang menyerang pribadi menutup peluang belajar.
- Gunakan kata yang tepat: “diduga” untuk hal yang belum terbukti, “terbukti” hanya bila sudah ada hasil pemeriksaan resmi.
- Saat merapikan figur, bandingkan setiap panel dengan berkas asli dari alat. Kesalahan kategori I paling sering lahir dari folder yang berantakan.
Poin Penting
- Survei menunjukkan sekitar 2% ilmuwan mengaku pernah memalsukan atau memodifikasi data, dan angka sebenarnya diduga lebih tinggi (Fanelli, 2009).
- Yang membedakan kekeliruan dari pelanggaran berat adalah niat menipu, tetapi wilayah abu-abu tetap berbahaya.
- Sekitar 1 dari 25 makalah yang diperiksa memuat duplikasi gambar bermasalah, dan pemeriksaan sebelum terbit terbukti efektif menekannya (Bik dkk., 2016).
- Gunakan kerangka FAKTA: Fakta, Aturan, Kadar niat, Terdampak, Arah perbaikan.
Jeda Sejenak
Pernahkah Anda tergoda “merapikan” data praktikum agar grafiknya terlihat lebih bagus? Di titik mana pada spektrum Gambar 4 tindakan itu berada?
Open Science: Membuka Jendela Tanpa Membukakan Jalan bagi Pemburu
2.1 Mengapa sains perlu terbuka
Transparansi, keterbukaan, dan kemampuan untuk diulang adalah nilai yang diakui hampir semua ilmuwan. Namun Nosek dkk. (2015) mencatat jurang antara nilai dan praktik, karena sistem penghargaan akademik lebih menyukai temuan baru daripada upaya verifikasi. Akibatnya, hasil yang tidak signifikan jarang terbit dan menumpuk di laci, sehingga gambaran ilmu menjadi berat sebelah. Mereka menyebutnya masalah aksi kolektif: semua pihak diuntungkan jika semua orang terbuka, tetapi tidak ada individu yang cukup terdorong untuk memulai sendirian. Untuk memecah kebuntuan itu, sebuah komite menyusun pedoman Transparency and Openness Promotion (TOP) bagi jurnal ilmiah.
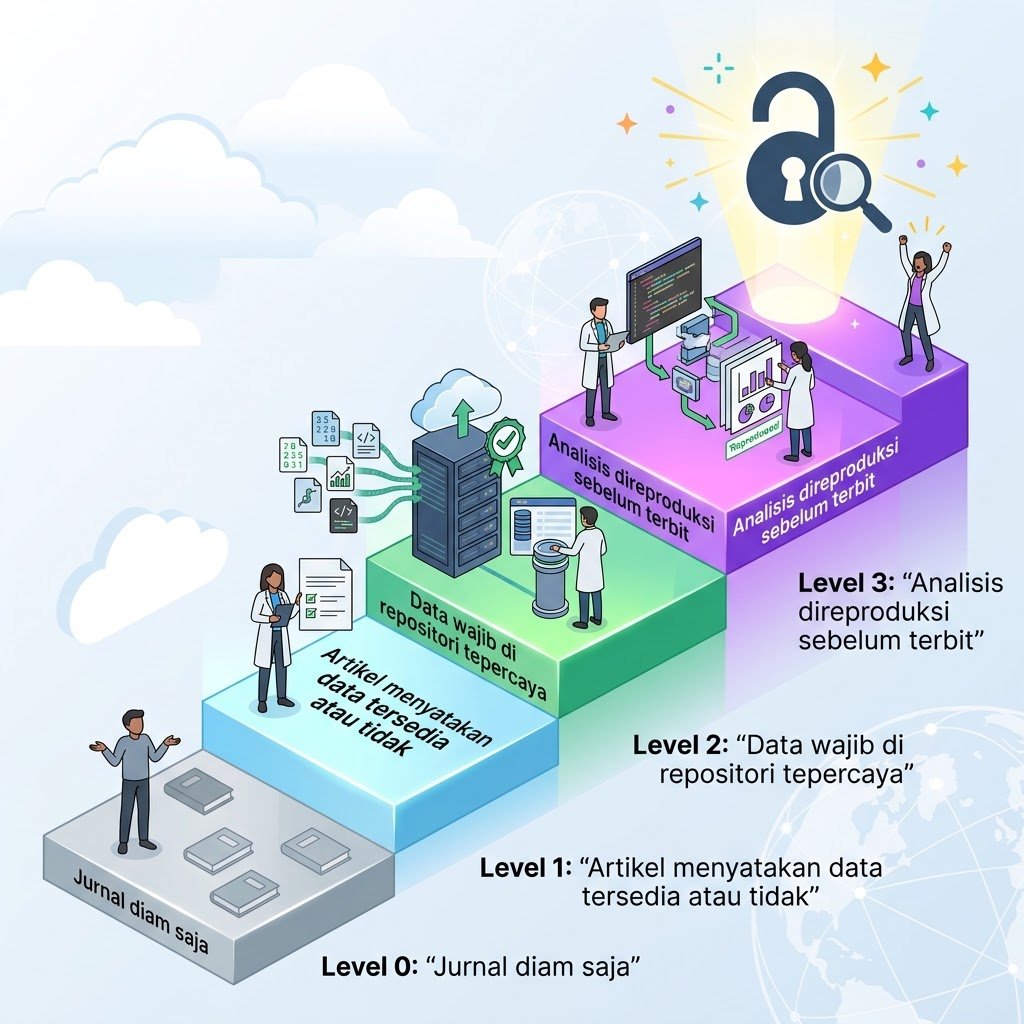
Pedoman TOP berisi delapan standar yang boleh diadopsi sebagian atau seluruhnya. Dua standar memberi penghargaan pada keterbukaan, yaitu sitasi untuk data, kode, dan materi, serta penerimaan studi replikasi. Empat standar menjelaskan apa saja yang perlu dibuka, yaitu rancangan dan analisis, materi penelitian, data, serta kode analisis. Dua standar sisanya berkaitan dengan prapendaftaran studi dan prapendaftaran rencana analisis sebelum data dikumpulkan. Setiap standar memiliki tiga tingkat, mulai dari sekadar menyatakan ketersediaan sampai mewajibkan analisis direproduksi secara independen sebelum terbit.
| Standar TOP | Maknanya | Wujudnya dalam riset biologi |
|---|---|---|
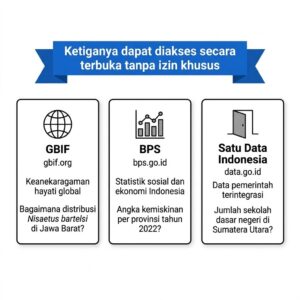
| Sitasi | Data, kode, dan materi disitasi seperti artikel | Menyitasi dataset GBIF atau sekuens GenBank lengkap dengan DOI atau nomor aksesi |
| Transparansi data | Data disimpan di repositori tepercaya | Tabel pengukuran lapangan diunggah ke Dryad, Figshare, atau Zenodo |
| Transparansi kode | Skrip analisis dapat diakses | Skrip R untuk analisis keanekaragaman ikut dibagikan |
| Transparansi materi | Bahan dan instrumen dapat dilacak | Nomor voucher herbarium, protokol primer, lembar pengamatan |
| Rancangan dan analisis | Metode dilaporkan lengkap | Kriteria inklusi sampel ditulis jelas sejak awal |
| Prapendaftaran studi | Keberadaan studi dicatat publik | Rencana survei didaftarkan sebelum turun lapangan |
| Prapendaftaran analisis | Rencana analisis ditetapkan lebih dulu | Memisahkan analisis konfirmatori dari eksploratori |
| Replikasi | Studi ulang dihargai dan diterbitkan | Menguji ulang temuan lama di lokasi atau populasi berbeda |
Sumber: diadaptasi dari Nosek dkk. (2015). Kolom contoh biologi adalah adaptasi penyusun.
2.2 Ketika keterbukaan justru melukai
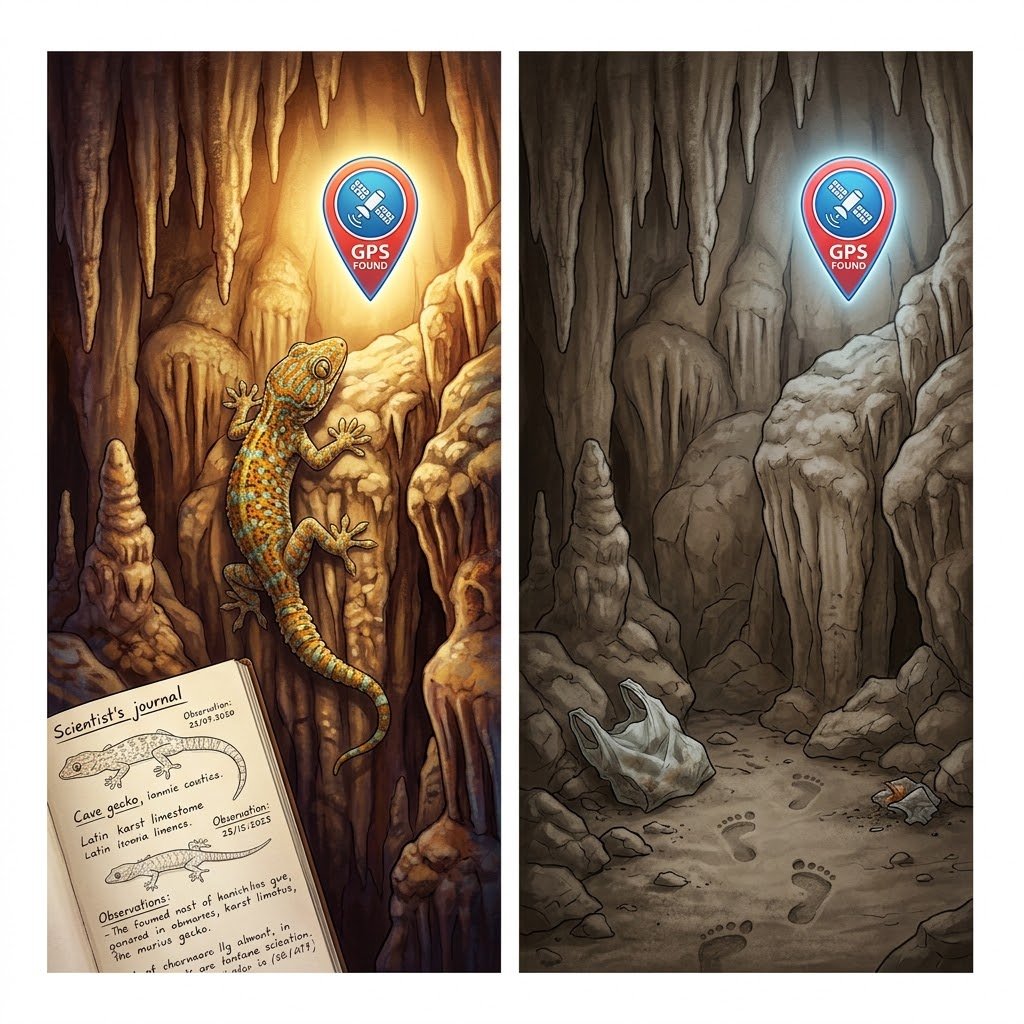
Keterbukaan bukan tanpa harga, dan biologi punya contoh yang sangat gamblang. Lindenmayer dan Scheele (2017) menyebutnya dilema penggunaan ganda, ketika informasi yang dimaksudkan untuk konservasi justru dipakai untuk merugikan keanekaragaman hayati. Mereka mencatat lebih dari 20 spesies reptil yang baru dideskripsikan telah menjadi sasaran perburuan, sebagian hanya dalam hitungan bulan setelah deskripsinya terbit. Dari pengalaman mereka sendiri di Australia, catatan lokasi kadal langka yang wajib diunggah ke atlas satwa daring milik pemerintah segera mengundang orang masuk tanpa izin ke lahan petani dan merusak habitat bebatuan. Kepercayaan antara peneliti dan pemilik lahan yang dibangun bertahun-tahun pun ikut terancam.
Studi Kasus Mini · Tokek Gua yang Hilang dari RumahnyaKasus nyata, dikisahkan dalam Lindenmayer dan Scheele (2017)
Goniurosaurus luii adalah tokek gua dari Tiongkok yang berpenampilan mencolok dan diminati kolektor satwa. Tidak lama setelah spesies ini dideskripsikan secara ilmiah, populasinya lenyap dari lokasi tipe, yaitu tempat spesimen acuannya pertama kali ditemukan. Lindenmayer dan Scheele bahkan mencatat bahwa ketika nama spesies semacam ini diketik di mesin pencari, isian otomatis langsung menawarkan kata kunci untuk membelinya. Publikasi yang niatnya memperkenalkan spesies kepada dunia ilmu justru berubah menjadi peta harta karun bagi pedagang satwa. Kasus ini menjadi pengingat bahwa koordinat GPS di tabel data kita bisa bernilai nyawa.
Jika Anda menemukan populasi anggrek langka di Taman Nasional Gunung Leuser, informasi apa yang akan Anda tulis di laporan, dan informasi apa yang akan Anda simpan?
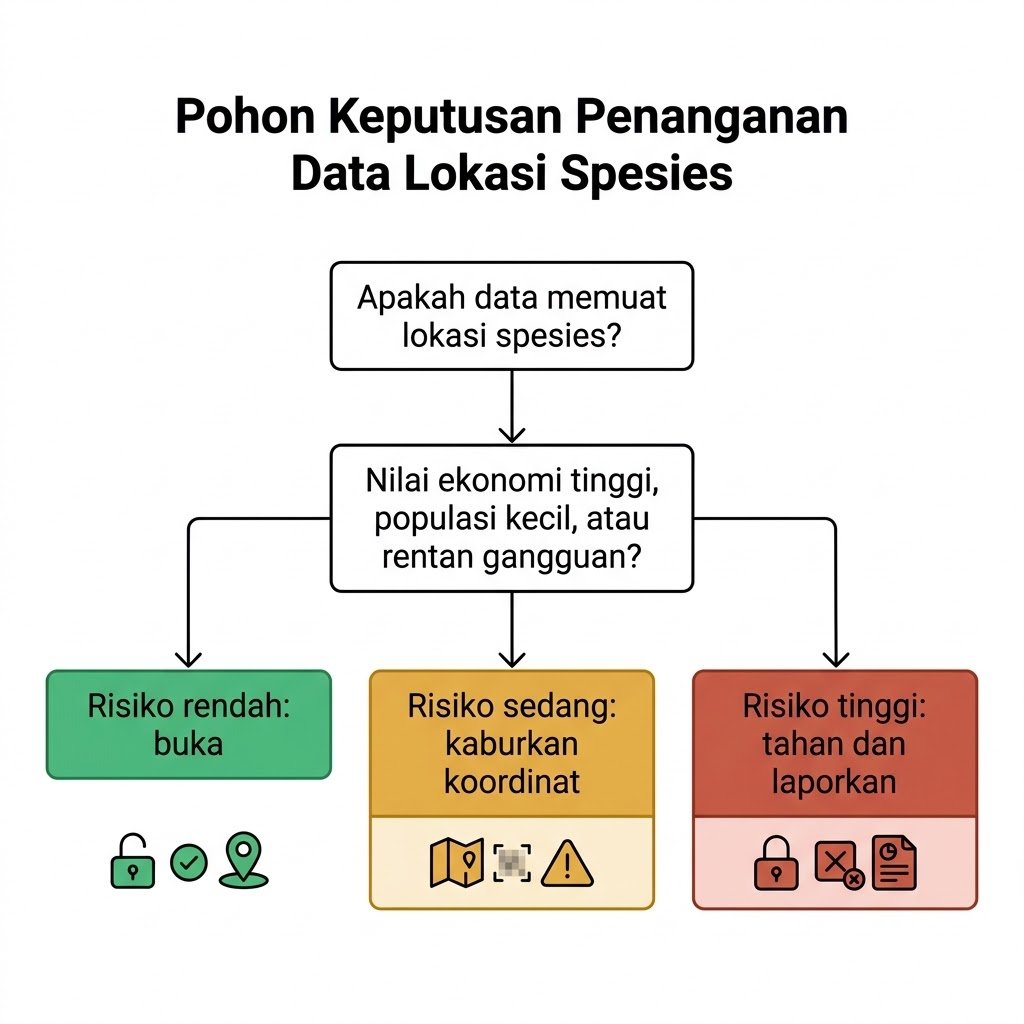
Jalan keluarnya bukan menutup semua data, melainkan menakar risikonya. Untuk spesies bernilai ekonomi tinggi dengan risiko besar, informasi lokasi dan habitat sebaiknya ditahan, sementara lembaga berwenang tetap diberi tahu dan jalur akses bagi pihak yang sah tetap dibuka. Untuk risiko sedang, data spasial dapat dikaburkan sehingga hanya lokasi umum yang ditampilkan dan data rinci hanya diberikan kepada pihak yang disetujui. Untuk risiko rendah, publikasi lokasi dan deskripsi habitat tetap layak dilakukan tanpa pembatasan. Beberapa jurnal taksonomi seperti Zootaxa bahkan sudah menerbitkan deskripsi spesies baru tanpa informasi lokasi.
| Tingkat risiko | Keputusan | Contoh data biologi |
|---|---|---|
| Rendah | Buka penuh | Kelimpahan serangga penyerbuk di kebun kampus; data fisiologi tanaman budidaya |
| Sedang | Batasi: kaburkan koordinat, berikan data rinci atas permintaan | Titik sarang burung dilindungi di hutan kota; lokasi tumbuhan obat yang mulai langka |
| Tinggi | Tahan: jangan publikasikan lokasi, laporkan ke otoritas | Populasi anggrek atau reptil endemik bernilai jual tinggi; lokasi baru spesies terancam punah |
Sumber: kerangka risiko dari Lindenmayer dan Scheele (2017); contoh disesuaikan penyusun.
2.3 Ketika aturan justru menghambat ilmu
Masalah keterbukaan juga bisa muncul dari arah sebaliknya, yaitu aturan yang terlalu ketat. Konvensi Keanekaragaman Hayati (CBD) mengikat 196 negara pihak untuk melestarikan keanekaragaman hayati, memanfaatkannya secara berkelanjutan, dan membagi keuntungan dari pemanfaatan sumber daya genetik secara adil. Tujuan terakhir itu dipertegas dalam Protokol Nagoya yang berlaku sejak 2014 melalui skema Akses dan Pembagian Keuntungan (ABS). Prathapan dkk. (2018), bersama 172 ilmuwan penanda tangan dari 35 negara, berpendapat bahwa banyak regulasi nasional turunan skema ini justru mempersulit penelitian biodiversitas oleh ilmuwan dalam negeri maupun kolaborasi internasional. Lebih dari 1.200 peneliti Brasil, misalnya, sampai mengajukan permohonan agar studi taksonomi dibedakan dari riset komersial.
Bagi negara megadiversitas seperti Indonesia, perdebatan ini sangat dekat dengan keseharian peneliti. Prathapan dan rekan mengingatkan bahwa dari sekitar 12 juta spesies eukariota di Bumi, kurang dari 2 juta yang sudah diberi nama, sementara sekitar 20% spesies terancam punah. Mereka mengusulkan agar penelitian nirlaba seperti inventarisasi dan taksonomi dibedakan dari riset komersial yang berujung pada hak kekayaan intelektual. Sebagai model, mereka menunjuk sistem multilateral dalam Perjanjian Benih (Seed Treaty) yang memfasilitasi sekitar 8.500 transfer materi genetik setiap minggu. Bagi Anda sebagai mahasiswa, pelajarannya ada dua: patuhi izin akses dan perjanjian transfer material, sekaligus pahami bahwa aturan yang baik seharusnya melindungi keanekaragaman hayati tanpa mematikan ilmunya.
“Keterbukaan adalah jendela, bukan pintu yang dicopot dari engselnya.”
Tips dan Trik Sebelum Membagikan Data Lapangan
- Periksa status konservasi setiap spesies dalam dataset Anda sebelum mengunggahnya ke platform publik.
- Untuk spesies sensitif, turunkan ketelitian koordinat atau tampilkan hanya nama kawasan.
- Pastikan sampel biologis dan data sekuens Anda dilengkapi izin penelitian dan dokumen transfer material yang sah.
- Tulis alasan pembatasan data secara terbuka di metadata. Menutup data dengan alasan yang jelas tetap termasuk sikap transparan.
Poin Penting
- Open Science memperkuat verifikasi dan replikasi. Pedoman TOP memuat 8 standar dengan 3 tingkat (Nosek dkk., 2015).
- Keterbukaan punya sisi gelap: data lokasi spesies langka dapat memicu perburuan dan kerusakan habitat (Lindenmayer & Scheele, 2017).
- Prinsipnya seterbuka mungkin, setertutup yang diperlukan, berdasarkan penilaian risiko.
- Aturan akses sumber daya genetik wajib dipatuhi, dan idealnya dirancang agar tidak mematikan riset nirlaba (Prathapan dkk., 2018).
Jeda Sejenak
Data Mini Riset kelompok Anda termasuk risiko rendah, sedang, atau tinggi? Apa alasannya?
Responsible AI: Asisten yang Fasih, tetapi Wajib Diperiksa
3.1 Ketika mesin mengarang daftar pustaka
Kecerdasan buatan generatif kini hadir di banyak meja belajar, termasuk untuk mencari literatur. Walters dan Wilder (2023) menguji keandalan kebiasaan ini dengan meminta ChatGPT-3.5 dan ChatGPT-4 menulis tinjauan pustaka singkat tentang 42 topik lintas bidang. Dari 84 naskah yang dihasilkan, mereka memeriksa 636 rujukan satu per satu di berbagai basis data. Hasilnya, 55% rujukan dari GPT-3.5 ternyata fiktif, sedangkan pada GPT-4 angkanya turun menjadi 18%. Di antara rujukan yang benar-benar ada pun, 43% rujukan GPT-3.5 dan 24% rujukan GPT-4 masih mengandung kesalahan substansial, seperti nama penulis, tahun, atau nomor halaman yang keliru.
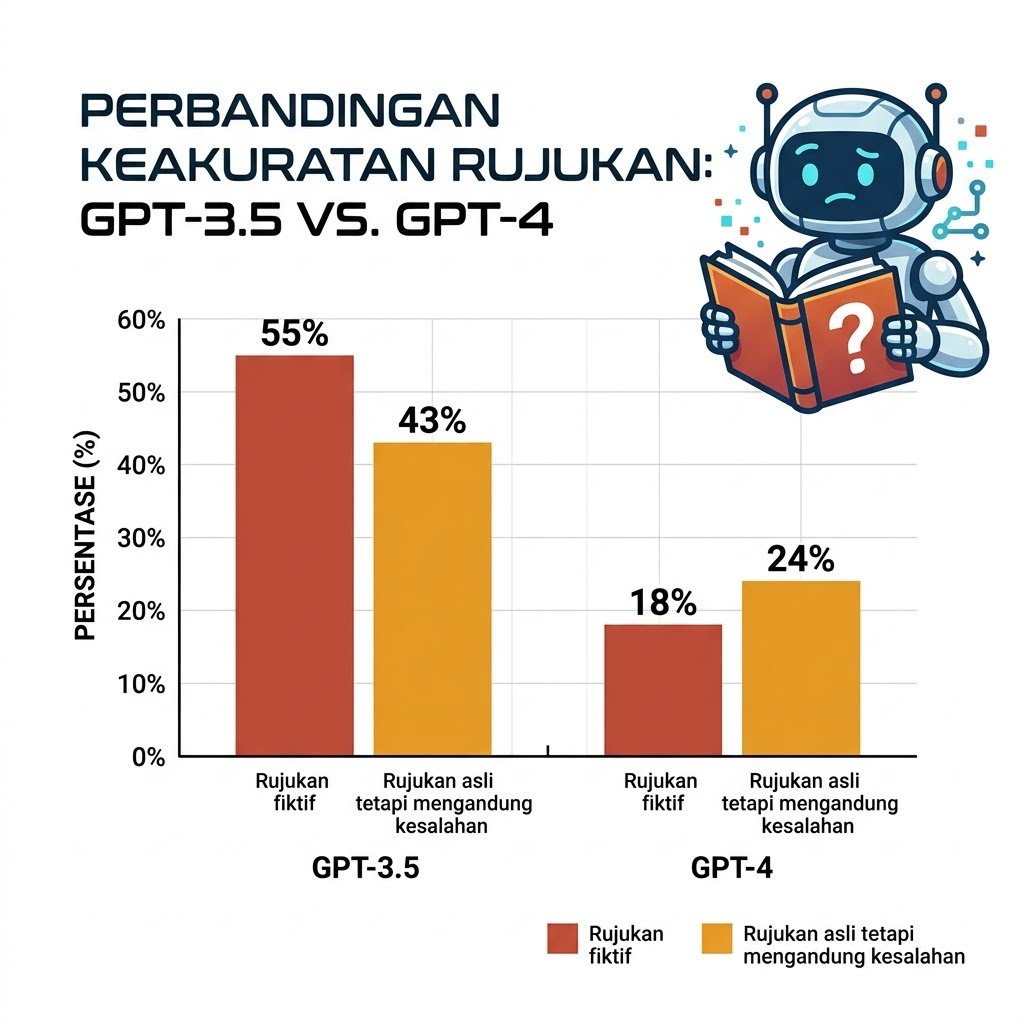
Mengapa mesin secanggih itu bisa mengarang? Walters dan Wilder menjelaskan bahwa ChatGPT pada dasarnya adalah alat pengolah bahasa, bukan alat pengolah informasi, sehingga ia meniru bentuk teks tanpa menjamin kebenaran isinya. Lebih mengkhawatirkan lagi, lima naskah yang diminta berupa tinjauan pustaka justru disajikan seperti studi empiris dengan metode dan hasil rekaan, dan salah satunya bahkan memuat koefisien korelasi serta nilai p yang dikarang. Model ini juga kerap bertahan pada jawaban keliru ketika diminta memeriksa ulang. Ibaratnya seperti pemandu wisata yang sangat fasih bercerita, tetapi sesekali menunjuk bangunan yang sebenarnya tidak pernah ada. Model yang Anda pakai hari ini mungkin sudah jauh lebih baik, tetapi prinsip verifikasinya tetap sama.
Studi Kasus Mini · Daftar Pustaka yang Terlalu SempurnaKisah rekaan untuk ilustrasi
Dimas meminta sebuah chatbot menyusun latar belakang proposal tentang mangrove di pesisir timur Sumatra Utara, lengkap dengan sepuluh rujukan. Hasilnya tampak meyakinkan, nama jurnalnya dikenal dan judul artikelnya terdengar sangat relevan. Karena dikejar tenggat, ia langsung menyalin semuanya ke laporan kelompok tanpa membuka satu pun artikelnya. Saat peer review, kelompok lain mencoba menelusuri DOI-nya dan tidak menemukan tiga di antaranya di basis data mana pun. Dimas tidak berniat menipu, tetapi kelalaiannya tetap menghasilkan rujukan fiktif dalam laporan yang ditandatangani seluruh anggota kelompok.
Evaluasi kasus Dimas dengan kerangka FAKTA. Di mana letak kadar niatnya, dan siapa saja yang ikut menanggung akibatnya?
3.2 Tata kelola AI: dari prinsip global ke kebiasaan harian
Kalau AI bisa keliru, siapa yang mengatur penggunaannya? Jobin dkk. (2019) memetakan 84 dokumen pedoman etika AI yang diterbitkan pemerintah, perusahaan, lembaga riset, dan organisasi internasional. Mereka menemukan sebelas prinsip etika, dan lima di antaranya muncul di lebih dari separuh dokumen, yaitu transparansi, keadilan, tidak merugikan, tanggung jawab, dan privasi. Namun kesepakatan itu lebih banyak di permukaan, karena setiap dokumen menafsirkan dan menerapkan prinsip yang sama dengan cara berbeda. Mereka juga mencatat bahwa suara dari Afrika, Amerika Selatan dan Tengah, serta Asia Tengah nyaris tidak terdengar dalam perdebatan global ini.
| Prinsip | Muncul di | Terjemahannya untuk mahasiswa biologi |
|---|---|---|
| Transparansi | 73 dari 84 dokumen | Nyatakan alat AI yang dipakai, untuk bagian apa, dan kapan |
| Keadilan | 68 dari 84 | Waspadai bias, misalnya AI yang hanya mengenal literatur dari negara tertentu |
| Tidak merugikan | 60 dari 84 | Jangan biarkan keluaran AI yang belum diperiksa masuk ke data atau kesimpulan |
| Tanggung jawab | 60 dari 84 | Penulis manusia tetap bertanggung jawab penuh atas naskah |
| Privasi | 47 dari 84 | Jangan mengunggah data pribadi responden atau data sensitif ke layanan AI publik |
Sumber: frekuensi dari Jobin dkk. (2019); kolom terjemahan adalah adaptasi penyusun.
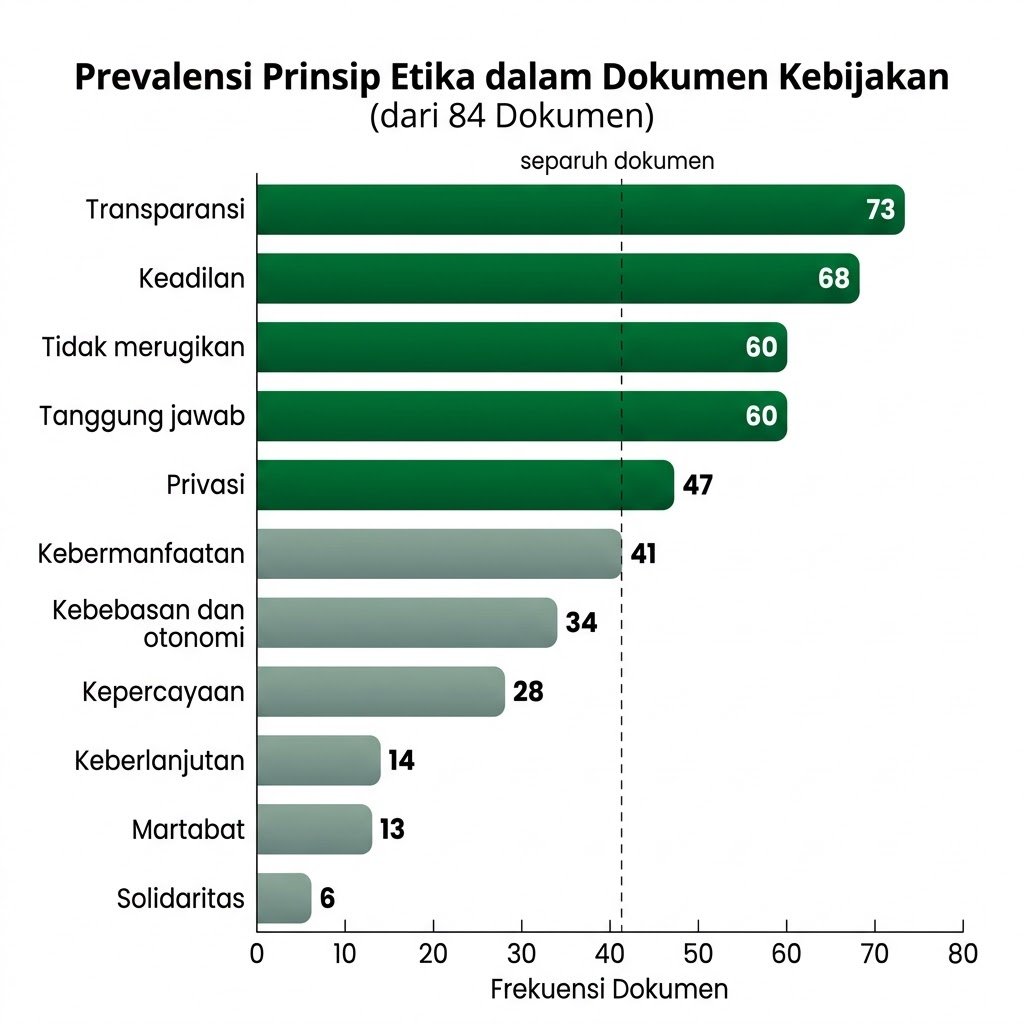
Sebagian besar pedoman itu bersifat hukum lunak, artinya tidak mengikat secara hukum tetapi berpengaruh besar pada praktik. Di level Anda sebagai mahasiswa, hukum lunak itu bisa diterjemahkan menjadi kebiasaan sehari-hari yang sederhana. Nyatakan dengan jujur di bagian mana AI membantu Anda, jangan memasukkan data sensitif ke layanan AI publik, dan periksa setiap klaim serta rujukan yang dihasilkannya. Yang terpenting, tanggung jawab atas naskah dan data tetap berada di tangan manusia, bukan mesin. Menariknya, Jobin dan rekan juga menemukan pedoman yang secara eksplisit memperingatkan agar kita tidak menaruh kepercayaan berlebihan pada AI.
“AI boleh membantu menulis, tetapi tanda tangan di bawah laporan tetap milik Anda.”
Tips dan Trik Memverifikasi Rujukan dari AI
- Salin DOI ke kolom pencarian doi.org. DOI yang tidak mengarah ke mana pun adalah tanda bahaya pertama.
- Cari judul persisnya di Google Scholar, lalu cocokkan nama penulis, tahun, jurnal, volume, dan halaman.
- Buka artikelnya dan baca bagian yang dikutip. Rujukan asli pun bisa dipakai untuk klaim yang tidak pernah ditulis penulisnya.
- Catat jejak penggunaan AI: nama alat, tanggal, perintah utama, dan bagian naskah yang dibantu.
Poin Penting
- Chatbot dapat mengarang rujukan dan data dengan sangat meyakinkan. Pada studi 2023, 55% rujukan GPT-3.5 dan 18% rujukan GPT-4 fiktif (Walters & Wilder, 2023).
- Lima prinsip yang paling disepakati dalam pedoman AI global: transparansi, keadilan, tidak merugikan, tanggung jawab, dan privasi (Jobin dkk., 2019).
- Aturan emas di kelas ini: AI sebagai alat bantu mengidentifikasi isu, manusia sebagai verifikator dan penanggung jawab.
Jeda Sejenak
Berapa banyak rujukan dalam tugas terakhir Anda yang benar-benar Anda baca sendiri? Jika jawabannya “tidak semua”, apa langkah pertama yang akan Anda ubah?
Uji Ketangguhan Data: Valid, Reliabel, Aman, dan Berkelanjutan
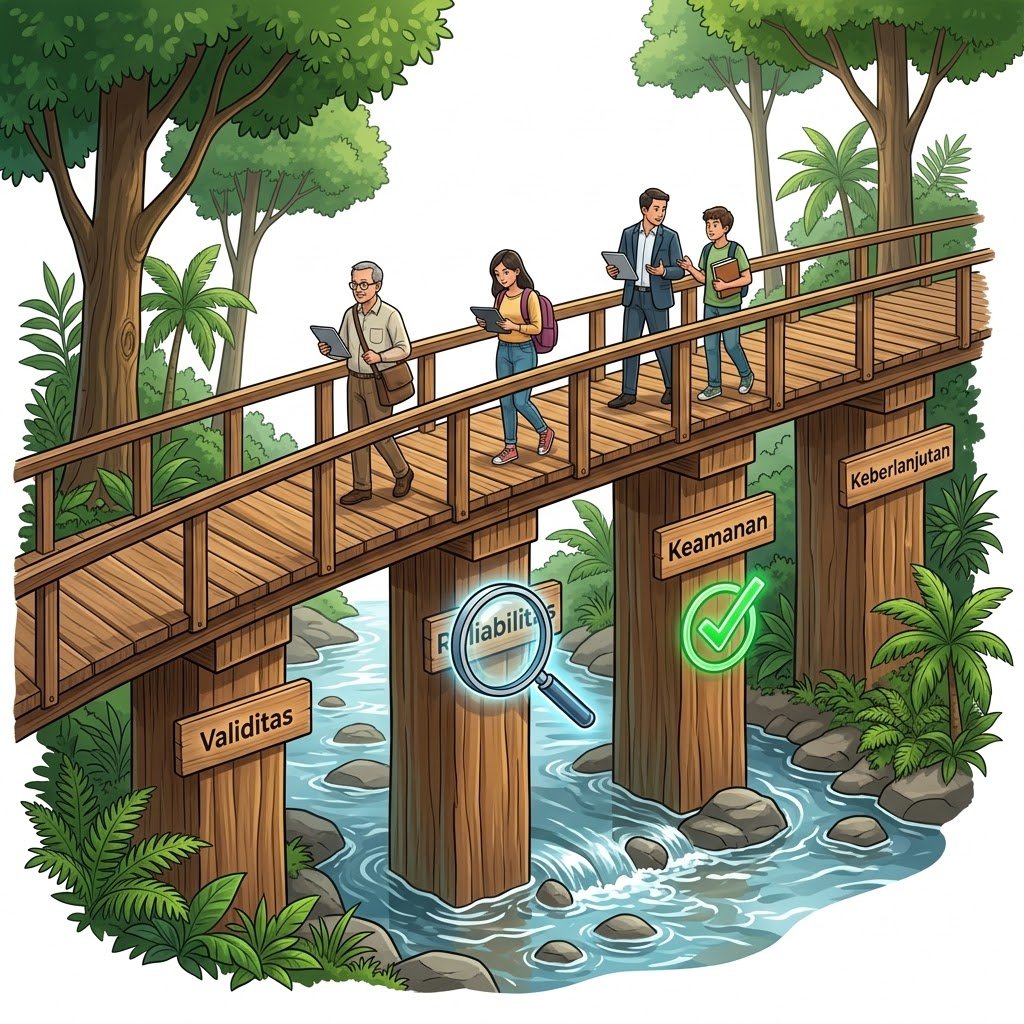
Data penelitian ibarat jembatan yang akan dilalui banyak orang setelah Anda: pembaca, peneliti lain, bahkan pembuat kebijakan. Sebelum jembatan dibuka, insinyur mengujinya dari beberapa sisi, dan data pun layak diperlakukan sama. Modul ini memakai empat uji ketangguhan, yaitu validitas, reliabilitas, keamanan, dan keberlanjutan. Validitas bertanya apakah data mengukur apa yang memang ingin diukur, sedangkan reliabilitas bertanya apakah hasilnya konsisten jika diulang. Keamanan bertanya apakah data terlindung dari kehilangan dan penyalahgunaan, sementara keberlanjutan bertanya apakah data masih bisa ditemukan dan dipakai bertahun-tahun kemudian.
| Uji | Pertanyaan kunci | Tanda bahaya | Kasus pembelajaran |
|---|---|---|---|
| Validitas | Apakah data lengkap dan benar-benar mewakili yang diukur? | Data mentah tidak ada, metadata kosong, satuan tidak jelas | Roche dkk. (2015) |
| Reliabilitas | Apakah hasil konsisten bila diulang orang lain? | Efek sangat besar dengan variasi nyaris nol; tidak ada replikasi | Clark dkk. (2020) |
| Keamanan | Apakah data terlindung dari hilang, rusak, dan bocor? | Satu salinan di satu laptop; kata sandi tersimpan di folder bersama | Wilson dkk. (2017) |
| Keberlanjutan | Apakah data masih ada dan terbaca 10 tahun lagi? | Disimpan pribadi; format usang; kontak penulis tidak aktif | Vines dkk. (2014) |
4.1 Reliabilitas: ketika hasil dramatis tidak bisa diulang
Studi Kasus Mini · Ikan Karang, CO2, dan Replikasi yang MengejutkanKasus nyata, dari Clark dkk. (2020) di jurnal Nature
Selama sekitar satu dekade, sejumlah studi berprofil tinggi melaporkan bahwa pengasaman laut membuat ikan karang kehilangan naluri menghindari predator. Beberapa studi bahkan melaporkan ikan kontrol hanya menghabiskan 0 sampai 10% waktunya di air beraroma predator, sedangkan ikan yang dipapar CO2 tinggi justru menghabiskan 90 sampai 100% waktunya di sana. Clark dkk. (2020) mencoba mengulang temuan tersebut selama tiga tahun, di dua lokasi di Australia, pada lebih dari 900 ikan dari enam spesies. Hasilnya, ikan dari kedua kelompok sama-sama menghindari aroma predator, dan efek dramatis yang dilaporkan sebelumnya tidak muncul.
Tim Clark juga melakukan simulasi bootstrap dengan 10.000 kali pengambilan sampel ulang dari data mereka yang besar. Simulasi itu menunjukkan bahwa kombinasi ukuran efek sangat besar dan variasi antarindividu yang sangat kecil, seperti yang dilaporkan sebelumnya, sangat tidak mungkin terjadi. Mereka mengingatkan bahwa variasi antarindividu adalah fenomena biologis yang mendasar, sehingga hasil yang nyaris tanpa variasi perlu disikapi dengan hati-hati. Clark dan rekan tidak menuduh siapa pun berbuat curang, dan mereka tetap menegaskan bahwa kenaikan CO2 adalah ancaman serius bagi laut melalui pemanasan. Yang mereka tunjukkan adalah pentingnya replikasi independen sebelum sebuah temuan dijadikan dasar prediksi besar.
Apa kemiripan antara “terlalu banyak data yang sama” dalam kasus Pruitt dan “variasi yang terlalu kecil” dalam kasus ini?
Cara kerja tim Clark sendiri layak ditiru sebagai contoh transparansi. Setiap percobaan direkam dengan video, dan sebelum ikan dimasukkan, selembar catatan berisi riwayat perlakuan ikan tersebut ditunjukkan ke kamera. Pergerakan ikan dianalisis dengan perangkat lunak pelacak otomatis, bukan dihitung manual oleh pengamat yang mengetahui perlakuannya. Seluruh data dan kode analisis diarsipkan di Figshare tanpa pembatasan akses. Dengan cara ini, siapa pun yang meragukan hasil mereka bisa memeriksanya sendiri.
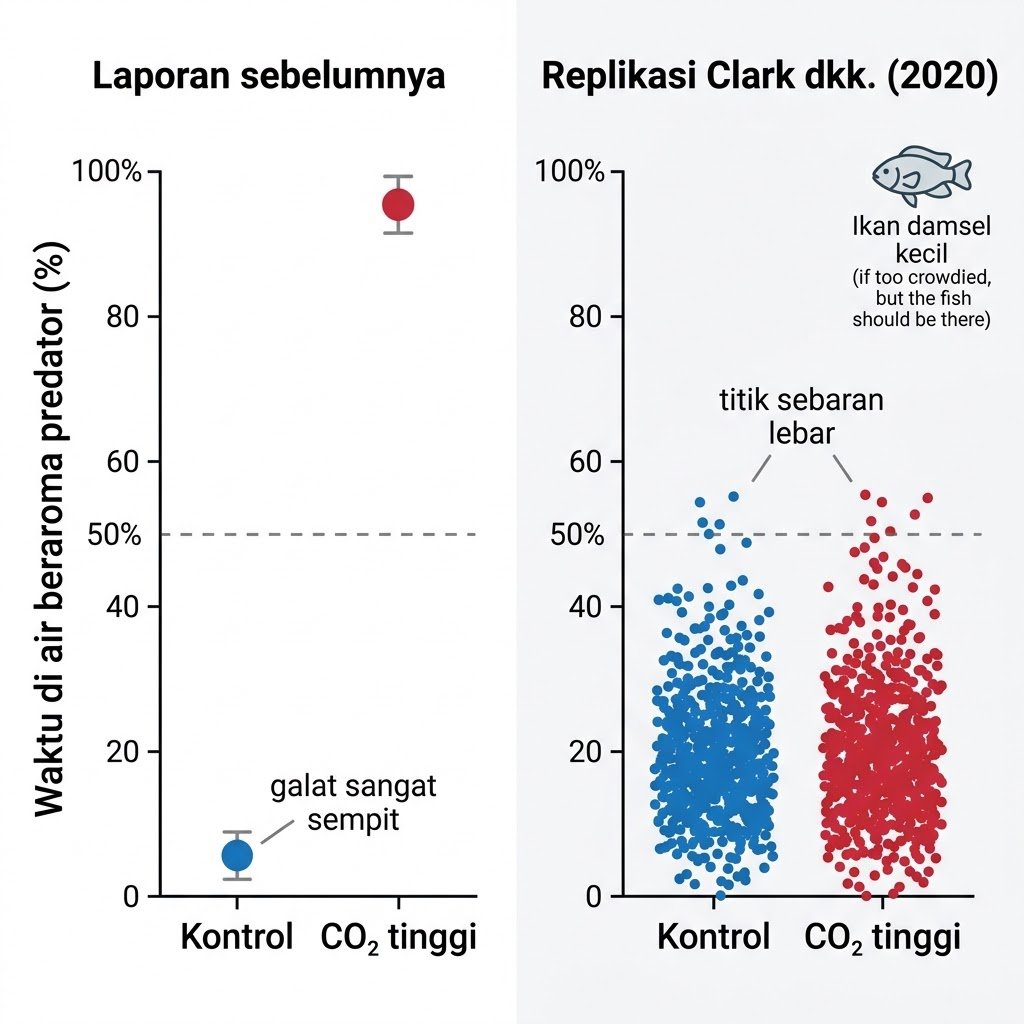
“Data yang terlalu rapi justru layak dicurigai, karena kehidupan tidak pernah seragam.”
4.2 Validitas dan kelengkapan: pintu terbuka, isi tak berlabel
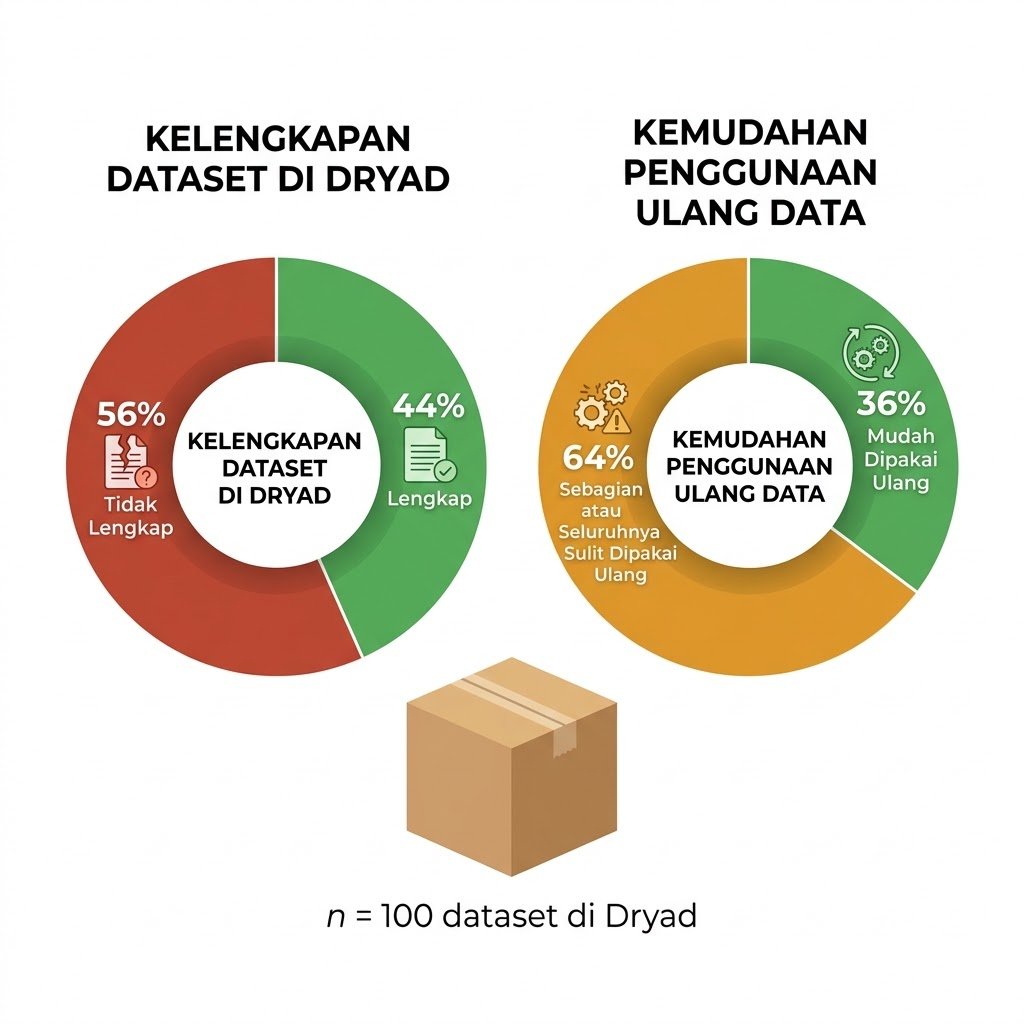
Membuka data belum tentu membuat data berguna. Roche dkk. (2015) memeriksa 100 dataset studi ekologi dan evolusi yang diarsipkan di repositori Dryad, berasal dari tujuh jurnal yang mewajibkan pengarsipan data. Hasilnya, 56% dataset tidak lengkap, sehingga sebenarnya tidak memenuhi kebijakan jurnalnya sendiri. Lebih lanjut, 64% dataset diarsipkan dengan cara yang sebagian atau sepenuhnya menghalangi pemakaian ulang. Penyebab yang paling sering adalah metadata yang tidak memadai, format berkas yang tidak terbaca mesin seperti PDF atau Word, serta tidak disertakannya data mentah.
Temuan ini seperti rumah yang pintunya dibuka lebar, tetapi semua perabotnya dibungkus kardus tanpa label. Tamu boleh masuk, tetapi tidak tahu mana meja dan mana lemari. Roche dan rekan menduga banyak peneliti sebenarnya paham kewajiban berbagi data, tetapi tidak pernah dilatih cara melakukannya dengan baik. Mereka juga menemukan bahwa dataset terbaik biasanya menautkan setiap berkas data secara eksplisit ke gambar dan analisis dalam makalah. Kebiasaan sederhana ini membuat penulis dan pembaca sama-sama bisa memastikan tidak ada titik data yang hilang.
4.3 Keberlanjutan: data yang menguap dimakan waktu
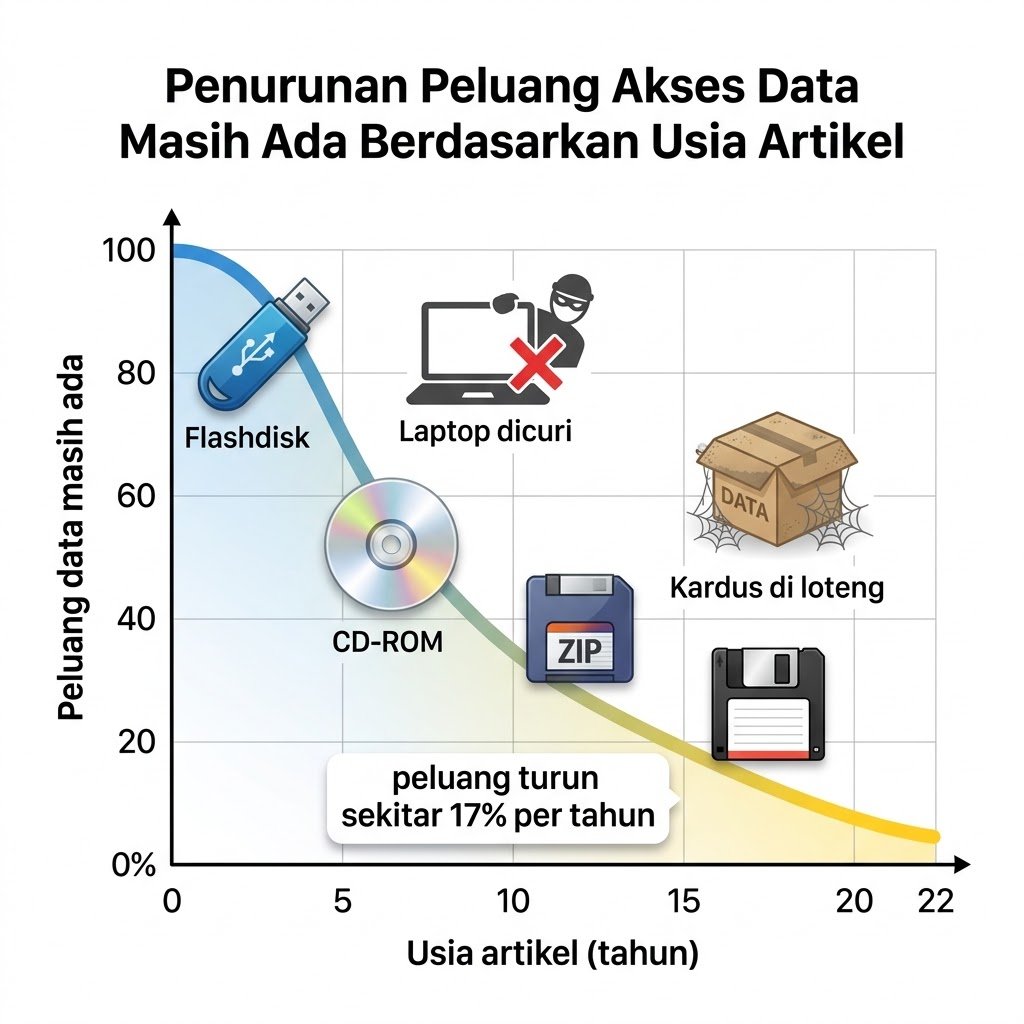
Bagaimana jika data cukup disimpan sendiri oleh penelitinya? Vines dkk. (2014) meminta dataset dari 516 artikel yang terbit antara 1991 dan 2011, semuanya berisi data morfologi tumbuhan atau hewan. Mereka hanya menerima 101 dataset, atau sekitar 19% dari seluruh artikel. Di antara penulis yang memberi kabar tentang status datanya, peluang data masih ada turun 17% untuk setiap tahun usia artikel. Peluang menemukan alamat surel penulis yang masih aktif pun turun sekitar 7% per tahun.
Jawaban para penulis terdengar sangat manusiawi. Ada data yang hilang bersama komputer yang dicuri, ada yang mungkin tersimpan di loteng rumah orang tua, dan ada yang tersimpan di disket atau Zip disk yang tidak bisa dibaca lagi karena perangkatnya sudah tidak ada. Padahal, banyak data biologi bersifat unik menurut waktu dan tempat, sehingga sekali hilang tidak dapat diganti. Vines dan rekan menyimpulkan bahwa dalam jangka panjang, data penelitian tidak bisa diandalkan hanya pada penyimpanan pribadi peneliti. Solusi yang mereka tawarkan adalah mewajibkan data dibagikan melalui arsip publik saat artikel diterbitkan.
4.4 Keamanan: ancaman terbesar sering kali sederhana
Keamanan data sering dibayangkan sebagai urusan peretas, padahal ancaman terbesar biasanya jauh lebih sederhana. Laptop hilang, cakram keras rusak, atau berkas asli tertimpa versi yang sudah diedit. Wilson dkk. (2017) menyarankan agar data mentah disimpan dalam bentuk aslinya, dijadikan hanya-baca, dan dicadangkan di lebih dari satu lokasi. Mereka juga mengingatkan agar kata sandi dan kunci akses tidak ikut tersimpan di repositori yang bisa dibuka orang lain, serta agar data yang dilindungi hukum tidak diunggah ke sistem publik. Untuk data yang menyangkut pribadi manusia, ingat kembali kewajiban perlindungan data pribadi yang sudah Anda pelajari di pertemuan 9.
Tips dan Trik
- Kunci berkas data mentah dengan pengaturan hanya-baca, lalu kerjakan analisis pada salinannya.
- Simpan cadangan di dua tempat yang berbeda, misalnya penyimpanan awan kampus dan cakram eksternal di rumah.
- Saat membagikan folder ke grup, periksa ulang isinya. Jangan sampai daftar nama dan nomor telepon narasumber ikut terbawa.
- Ingat semboyan Wilson dkk. (2017): penyimpanan itu murah, waktu Anda yang mahal.
Poin Penting
- Uji data dari empat sisi: validitas, reliabilitas, keamanan, dan keberlanjutan.
- Temuan dramatis dengan variasi yang nyaris nol layak diuji ulang, dan replikasi yang transparan adalah bentuk tanggung jawab ilmiah (Clark dkk., 2020).
- Data terbuka belum tentu data berguna: 56% dataset publik yang diperiksa tidak lengkap (Roche dkk., 2015).
- Data yang hanya disimpan pribadi cenderung hilang, dengan peluang bertahan turun 17% per tahun (Vines dkk., 2014).
Jeda Sejenak
Jika laptop Anda hilang malam ini, data Mini Riset mana yang ikut hilang untuk selamanya?
Praktik Terbaik: Kebiasaan Kecil yang Menyelamatkan Data
Setelah melihat begitu banyak cara data bisa salah, wajar jika Anda bertanya harus mulai dari mana. Wilson dkk. (2017) menjawabnya dengan konsep praktik yang cukup baik, yaitu seperangkat kebiasaan minimum yang bisa diterapkan siapa pun tanpa harus menjadi ahli pemrograman. Mereka hanya memilih praktik yang dipakai banyak peneliti dan masih dipakai berbulan-bulan setelah pertama dicoba, karena saran yang tidak dijalankan tidak ada gunanya. Banyak saran itu ditujukan untuk kolaborator yang paling Anda pedulikan, yaitu diri Anda sendiri di masa depan. Seperti kelakar mereka, diri Anda tiga bulan lalu tidak akan pernah membalas surel Anda.
| No | Kebiasaan | Contoh penerapan | Sumber |
|---|---|---|---|
| 1 | Simpan data mentah apa adanya | Foto lembar data lapangan dan berkas asli alat disimpan terpisah, hanya-baca | Wilson dkk. (2017) |
| 2 | Cadangkan di lebih dari satu lokasi | Awan kampus dan cakram eksternal | Wilson dkk. (2017) |
| 3 | Susun data rapi | Satu kolom satu variabel, satu baris satu pengamatan | Wilson dkk. (2017) |
| 4 | Catat setiap langkah pengolahan | Skrip analisis atau catatan langkah di berkas teks | Wilson dkk. (2017) |
| 5 | Beri nama berkas yang bermakna | 2026-05_sibayak_panjangdaun.csv, bukan hasil1.csv | Wilson dkk. (2017) |
| 6 | Lengkapi metadata dan README | Penjelasan setiap kolom, singkatan, dan satuan | Roche dkk. (2015) |
| 7 | Pakai format terbuka | CSV untuk tabel, bukan PDF atau Word | Roche dkk. (2015) |
| 8 | Arsipkan di repositori ber-DOI dengan lisensi jelas | Zenodo, Figshare, atau Dryad dengan lisensi CC0 atau CC BY | Wilson dkk. (2017); Roche dkk. (2015) |
| 9 | Tautkan data ke gambar dan analisis | Kolom atau berkas yang menyebut “data untuk Gambar 2” | Roche dkk. (2015) |
| 10 | Minta rekan memeriksa | Anggota kelompok lain membaca ulang data dan metadata | Roche dkk. (2015) |
5.1 Data rapi: satu kolom, satu makna
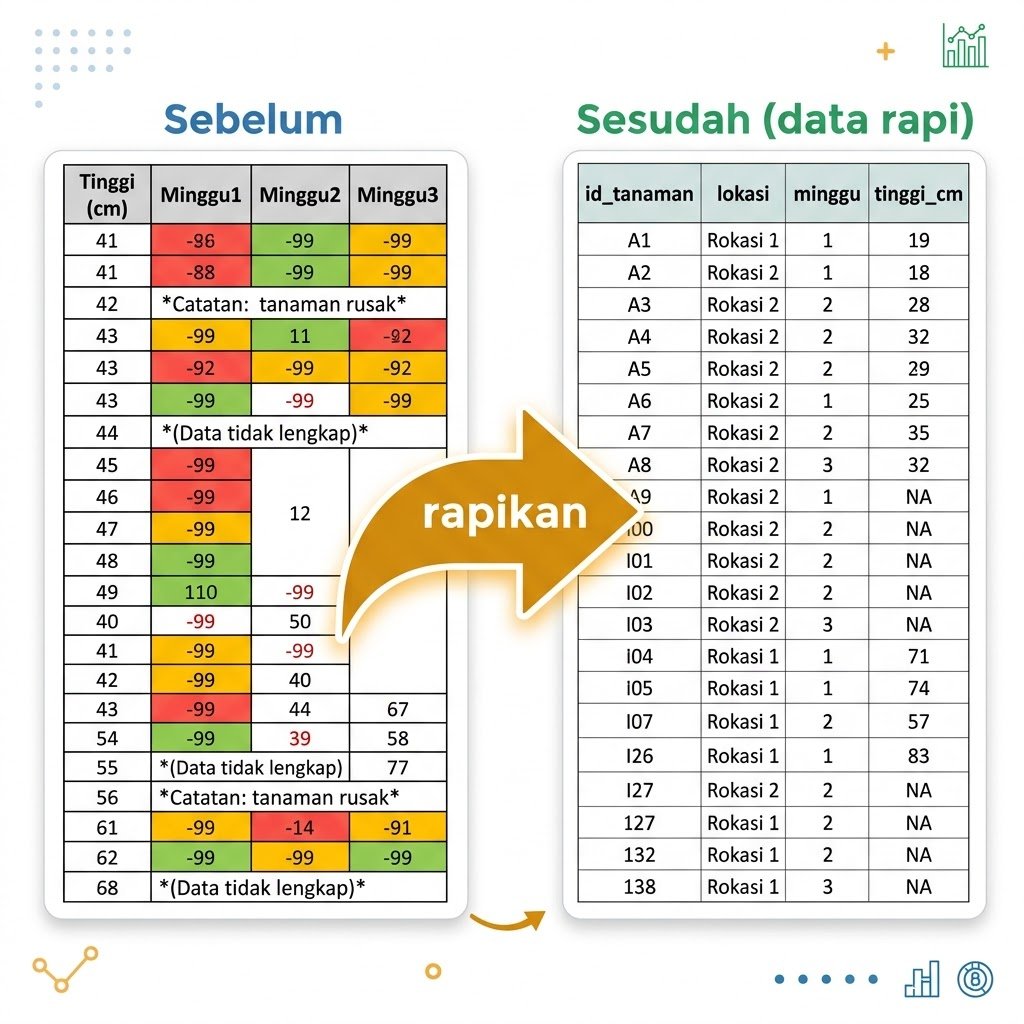
Salah satu kebiasaan yang paling berdampak adalah menyusun data rapi. Prinsipnya hanya dua: setiap kolom berisi satu variabel, dan setiap baris berisi satu pengamatan. Misalnya, jangan membuat kolom bernama jantan_diberi_perlakuan, tetapi pisahkan menjadi kolom jenis kelamin dan kolom perlakuan. Satuan sebaiknya ditulis di metadata atau nama kolom, sehingga isi sel cukup berupa angka 3,4 dan bukan 3,4 kg. Kode untuk data kosong seperti -99 sebaiknya diganti dengan NA agar tidak ikut terhitung sebagai angka.
5.2 Rumah yang tertata untuk proyek Anda
Kebiasaan berikutnya adalah menata folder proyek dengan pola yang sama setiap kali. Wilson dan rekan menyarankan satu folder untuk setiap proyek, dengan subfolder terpisah untuk data mentah, dokumen, hasil olahan, dan skrip. Di folder utama diletakkan berkas README yang menjelaskan isi proyek, berkas LICENSE yang menyatakan lisensi, dan berkas CITATION yang menjelaskan cara menyitasi proyek tersebut. Mereka juga menyarankan catatan perubahan bertanggal, dengan entri terbaru di bagian paling atas. Pola ini membuat siapa pun, termasuk Anda sendiri setahun kemudian, bisa langsung memahami isi proyek tanpa harus bertanya.
MiniRiset_Kelompok3_Mangrove/
|-- README.txt          (tujuan, anggota, kontak, cara membaca data)
|-- LICENSE.txt         (misalnya CC BY 4.0)
|-- CITATION.txt        (cara menyitasi dataset ini)
|-- data/
|   |-- mentah/2026-09_percut_transek_raw.csv   (hanya-baca)
|   |-- metadata_kolom.txt
|-- doc/
|   |-- DMP_kelompok3.docx
|   |-- catatan_perubahan.txt
|-- results/
|   |-- tabel_kerapatan_bersih.csv
|   |-- gambar_kerapatan_per_zona.png
|-- src/
    |-- olah_data_transek.R
Struktur diadaptasi dari contoh tata letak proyek dalam Wilson dkk. (2017).
Studi Kasus Mini · Laptop Fajar dan Berkas “Fix Banget”Kisah rekaan untuk ilustrasi
Kelompok 4 sedang menyusun Mini Riset tentang kualitas air Sungai Deli, dan seluruh pengolahan data dipegang Fajar karena ia yang paling mahir memakai Excel. Semua berkas tersimpan di laptopnya dengan nama yang hanya ia pahami sendiri, seperti fix2.xlsx, fix2_revisi.xlsx, dan fixbanget.xlsx. Dua hari menjelang tenggat, laptop itu terkena tumpahan air dan tidak mau menyala lagi. Anggota lain memang menyimpan salinan yang pernah dikirim lewat pesan grup, tetapi tidak ada yang yakin berkas mana yang paling mutakhir. Lebih repot lagi, tidak seorang pun ingat rumus yang dipakai untuk menghitung indeks pencemarannya, karena langkah pengolahan itu tidak pernah dicatat di mana pun.
Kelompok 4 akhirnya mengulang seluruh pengolahan dalam semalam, dan angka yang keluar sedikit berbeda dari tabel yang sudah mereka presentasikan minggu sebelumnya. Perbedaan itu bukan kecurangan, melainkan akibat langkah kerja yang tidak terdokumentasi sehingga tidak bisa diulang persis. Kejadian ini merugikan mereka dua kali, yaitu waktu yang terbuang dan rasa percaya diri yang goyah ketika dosen bertanya mengapa angkanya berubah. Padahal tiga kebiasaan sederhana sudah cukup mencegah semuanya: mencadangkan data di dua tempat, memberi nama berkas yang bermakna, dan mencatat setiap langkah pengolahan. Menariknya, tidak satu pun dari ketiganya memerlukan perangkat lunak khusus atau biaya tambahan.
Telusuri kelompok Anda sendiri: siapa yang memegang berkas aslinya, dan apakah anggota lain bisa mengulang pengolahan itu tanpa bertanya kepada orang tersebut?
“Kolaborator terpenting Anda adalah diri Anda sendiri, tiga bulan dari sekarang.”Terinspirasi dari Wilson dkk. (2017)
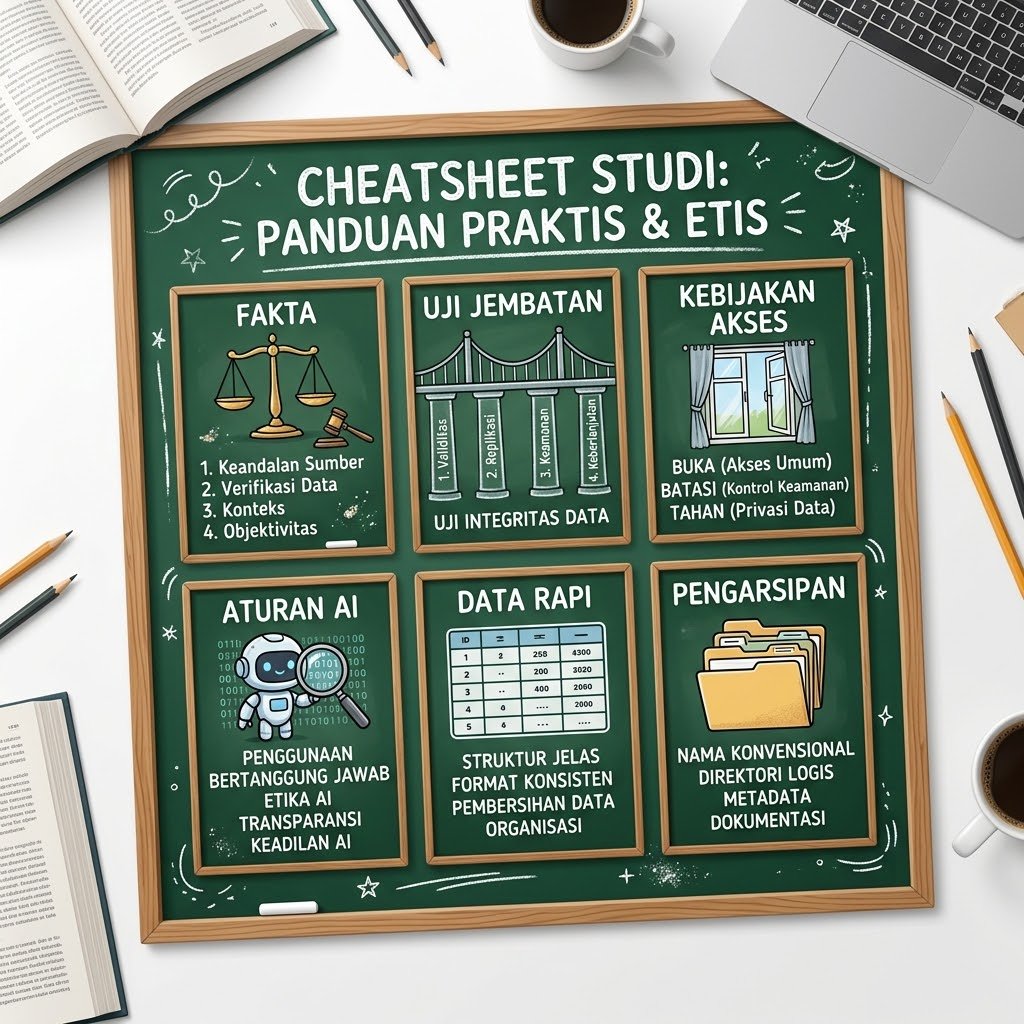
Cheat Sheet
Satu Halaman untuk Menilai dan Merawat Data
Evaluasi kasus: FAKTA
- Fakta dan buktinya
- Aturan yang dipertaruhkan
- Kadar niat
- Terdampak
- Arah perbaikan
Empat uji ketangguhan
- Valid: lengkap, ada data mentah dan metadata
- Reliabel: bisa diulang, variasinya wajar
- Aman: cadangan ganda, tanpa bocoran
- Berkelanjutan: repositori ber-DOI
Buka, batasi, atau tahan?
- Risiko rendah: buka penuh
- Risiko sedang: kaburkan koordinat
- Risiko tinggi: tahan, laporkan ke otoritas
- Sampel genetik: pastikan izin dan dokumen transfer
Aturan pakai AI
- Nyatakan penggunaannya
- Periksa setiap rujukan dan klaim
- Jangan unggah data sensitif
- Tanggung jawab tetap pada manusia
Data rapi
- 1 kolom = 1 variabel
- 1 baris = 1 pengamatan
- Satuan di metadata, kosong = NA
- Simpan dalam format CSV
Nama dan folder
- tanggal_lokasi_isi.csv
- data/, doc/, results/, src/
- README, LICENSE, CITATION
- Catatan perubahan bertanggal
Poin Penting
- Praktik terbaik tidak harus rumit. Mulailah dari kebiasaan minimum yang konsisten (Wilson dkk., 2017).
- Data rapi, metadata jelas, format terbuka, dan repositori ber-DOI adalah empat investasi termurah untuk data Anda.
- Kebiasaan ini juga menjadi kriteria peer review DMP pada aktivitas pertemuan ini.
Jeda Sejenak
Dari sepuluh kebiasaan di tabel awal bab ini, mana yang sudah dijalankan kelompok Anda, dan mana yang akan Anda mulai minggu ini?
Dari Membaca ke Menilai: Aktivitas Pertemuan 10 dan Mini Riset Akhir
Sekarang saatnya semua alat di modul ini dipakai sungguhan. Pada pertemuan tatap muka, kelompok Anda akan mengevaluasi satu studi kasus dengan kerangka FAKTA, lalu melakukan peer review terhadap DMP milik kelompok lain. AI generatif boleh dipakai untuk membantu mengidentifikasi isu etika, dengan syarat setiap temuannya diverifikasi terhadap pedoman etika dan literatur di modul ini. Hasil diskusi dan masukan dari peer review kemudian dipakai untuk menyempurnakan Mini Riset menjadi laporan akhir. Seluruh rangkaian ini melatih kejujuran, tanggung jawab, kepedulian, etika berkomunikasi, dan kerja sama.
A. Alur kegiatan tatap muka (2 × 50 menit)
| Waktu | Kegiatan | Keluaran |
|---|---|---|
| 10 menit | Apersepsi: kembali ke kasus Rina, pembagian kasus per kelompok | Setiap kelompok memegang satu kasus |
| 30 menit | Evaluasi kasus dengan kerangka FAKTA; AI generatif dipakai untuk memetakan isu, lalu diverifikasi | Lembar FAKTA terisi, lengkap dengan catatan verifikasi |
| 30 menit | Peer review DMP kelompok lain dengan rubrik di bawah | Formulir peer review |
| 20 menit | Presentasi singkat hasil evaluasi kasus (maksimal 3 menit per kelompok) dan penguatan dosen | Rangkuman pelajaran kelas |
| 10 menit | Penutup dan penjelasan tugas Mini Riset Akhir | Rencana revisi kelompok |
B. Bank studi kasus
| Kasus | Isu utama | Bahan bacaan |
|---|---|---|
| 1. Laba-laba dan data yang berulang | Dugaan manipulasi data | Bab 1; Pennisi (2020) |
| 2. Duplikasi gambar gel | Manipulasi gambar dan kekeliruan penyusunan figur | Bab 1; Bik dkk. (2016) |
| 3. Tokek gua dan kadal di lahan petani | Data terbuka yang membahayakan spesies | Bab 2; Lindenmayer dan Scheele (2017) |
| 4. Daftar pustaka Dimas | Penggunaan AI tanpa verifikasi | Bab 3; Walters dan Wilder (2023) |
| 5. Sampel daun yang dikirim ke luar negeri (rekaan) | Penggunaan material dan data genetik tanpa izin: sampel dikirim ke laboratorium mitra tanpa izin penelitian dan dokumen transfer material | Bab 2; Prathapan dkk. (2018) |
| 6. Grup WhatsApp etnobotani (rekaan) | Pelanggaran privasi: rekaman wawancara, nama, dan alamat informan pengobat tradisional dibagikan ke grup angkatan | Bab 4; materi P9 tentang perlindungan data pribadi |
C. Rubrik peer review DMP
Peer review bukan ajang mencari kesalahan, melainkan kesempatan saling menguatkan sebelum laporan dikumpulkan. Berikan skor 1 sampai 4 untuk setiap kriteria berdasarkan bukti yang benar-benar tertulis di DMP, bukan berdasarkan dugaan Anda tentang maksud penulisnya. Tulis komentar dengan bahasa yang santun, spesifik, dan disertai saran yang bisa langsung dikerjakan. Ingat bahwa kelompok yang Anda nilai juga sedang belajar, persis seperti kelompok Anda. Umpan balik yang baik biasanya menyebut apa yang sudah kuat sebelum menunjukkan apa yang perlu diperbaiki.
| Kriteria | 4 (Sangat baik) | 3 (Baik) | 2 (Cukup) | 1 (Perlu perbaikan) |
|---|---|---|---|---|
| Sumber data | Asal, izin, dan lisensi setiap data jelas dan terlacak | Asal jelas, izin atau lisensi sebagian | Asal disebut tanpa izin atau lisensi | Sumber tidak jelas |
| Risiko etika | Risiko teridentifikasi lengkap beserta mitigasinya | Risiko teridentifikasi, mitigasi kurang rinci | Risiko disebut umum | Tidak ada analisis risiko |
| Keamanan dan privasi | Cadangan ganda, akses terbatas, data pribadi dilindungi | Ada cadangan dan pengaturan akses | Hanya menyebut “disimpan dengan aman” | Tidak dibahas |
| Dokumentasi | Ada metadata, README, penamaan berkas yang konsisten | Metadata ada, penamaan belum konsisten | Dokumentasi minim | Tidak ada dokumentasi |
| Berbagi dan keberlanjutan | Repositori ber-DOI, lisensi, dan tingkat keterbukaan sesuai risiko | Rencana berbagi jelas, repositori belum ditentukan | Rencana berbagi samar | Tidak ada rencana berbagi |
Format Umpan Balik “2-2-1”
- 2 kekuatan DMP yang layak dipertahankan.
- 2 perbaikan yang paling penting, masing-masing dengan saran konkret.
- 1 pertanyaan yang membantu kelompok pemilik DMP berpikir lebih dalam.
D. Tugas kelompok: Mini Riset Akhir
Laporan akhir Mini Riset adalah bukti bahwa kelompok Anda mampu mengevaluasi penerapan etika, keamanan, dan pengelolaan data pada penelitian nyata. Susunlah laporan dengan memanfaatkan hasil diskusi kasus dan masukan dari peer review, bukan sekadar menyalin laporan tahap 2. Setiap rekomendasi perbaikan sebaiknya dapat ditelusuri kembali ke masukan atau temuan tertentu. Jika menggunakan AI generatif, tuliskan pernyataan penggunaannya di bagian akhir laporan. Pastikan pula setiap rujukan sudah diverifikasi sesuai tips di Bab 3.
Isi laporan
- Deskripsi penelitian dan sumber data
- Identifikasi potensi risiko etika
- Evaluasi keamanan dan privasi data
- Data Management Plan (versi revisi)
- Rekomendasi perbaikan pengelolaan data
- Daftar pustaka (APA Style)
Lampiran wajib
- Lembar FAKTA hasil diskusi kasus
- Formulir peer review yang diterima kelompok
- Tabel tanggapan: masukan, tindakan, dan letak perubahan
- Pernyataan penggunaan AI (bila ada)
| Komponen penilaian laporan | Bobot |
|---|---|
| Deskripsi penelitian dan sumber data | 10% |
| Identifikasi risiko etika | 20% |
| Evaluasi keamanan dan privasi | 20% |
| DMP revisi (kualitas dan tindak lanjut peer review) | 25% |
| Rekomendasi perbaikan | 15% |
| Daftar pustaka dan verifikasi rujukan | 10% |
Poin Penting Pengumpulan
- Laporan dikumpulkan dalam bentuk PDF melalui komisaris kelas, sesuai tenggat yang disampaikan dosen.
- Gunakan nama berkas yang bermakna: P10_MiniRisetAkhir_Kelompok[nomor].pdf.
- Pemeriksaan kesamaan naskah dengan Turnitin bersifat opsional dan mengikuti ketersediaan akses.
Kembali ke Rina, Kembali ke Diri Sendiri
Ingat Rina dan tabel yang terlalu rapi di awal modul? Kini Anda punya alat untuk menilainya dengan tenang. Faktanya, sebagian data lokasi kedua bukan hasil pengukuran, dan itu termasuk fabrikasi, seberapa kecil pun jumlahnya. Rina tidak perlu menghakimi seniornya, tetapi ia bisa mengusulkan agar data yang ditambal dihapus, ditandai sebagai data kosong, lalu dilaporkan secara jujur di metodologi. Jika sulit dibicarakan berdua, pembimbing adalah tempat yang tepat untuk meminta arahan, karena menjaga integritas data adalah tanggung jawab bersama, bukan beban satu orang.
Pertanyaan untuk Direnungkan
1. Kasus mana di modul ini yang paling mengusik Anda, dan mengapa?
2. Jika data Mini Riset kelompok Anda diaudit besok pagi, bagian mana yang paling Anda khawatirkan?
3. Kapan terakhir kali Anda memakai AI tanpa memeriksa hasilnya? Apa yang akan Anda lakukan berbeda?
4. Apa satu kebiasaan pengelolaan data yang akan Anda pertahankan sampai skripsi nanti?
Janji kecil untuk data saya
- Saya tidak akan mengarang, menambal, atau membelokkan data, sekecil apa pun.
- Saya akan menyimpan data mentah dan mencadangkannya di lebih dari satu tempat.
- Saya akan menilai risiko sebelum membagikan data lokasi spesies.
- Saya akan memeriksa setiap rujukan dan klaim yang dibantu AI.
- Saya akan berani bertanya ketika melihat praktik yang meragukan.
Refleksi bukan untuk membuat Anda merasa bersalah, melainkan untuk membuat langkah berikutnya lebih mantap. Setiap peneliti hebat pernah keliru, dan yang membedakan mereka adalah kesediaan untuk memeriksa dan memperbaiki. Tuliskan jawaban Anda di buku catatan pribadi, karena pertanyaan-pertanyaan ini akan relevan kembali saat Anda merancang proposal di pertemuan berikutnya. Data yang Anda rawat dengan jujur hari ini adalah reputasi yang Anda bangun untuk masa depan. Sampai jumpa di pertemuan 11, tempat kita mulai merancang penelitian berbasis data.
“Integritas bukan tentang tidak pernah salah, tetapi tentang tidak pernah menyembunyikan kesalahan.”
Glosarium dan Daftar Pustaka
Glosarium
| Istilah | Arti sederhana |
|---|---|
| Fabrikasi | Mengarang data atau hasil yang tidak pernah diperoleh |
| Falsifikasi | Mengubah atau membelokkan data, metode, atau hasil agar sesuai keinginan |
| Praktik penelitian meragukan | Tindakan di wilayah abu-abu, misalnya membuang data tanpa kriteria yang jelas |
| Retraksi | Penarikan resmi sebuah artikel yang sudah terbit |
| Replikasi | Mengulang penelitian untuk menguji apakah hasilnya konsisten |
| Bootstrap | Teknik statistik yang mengambil sampel ulang berkali-kali dari data untuk memperkirakan sebaran hasil |
| Prapendaftaran | Mencatat rencana studi dan analisis secara publik sebelum data dikumpulkan |
| Lokasi tipe | Tempat spesimen acuan suatu spesies pertama kali ditemukan |
| Akses dan Pembagian Keuntungan (ABS) | Skema yang mengatur izin mengambil sumber daya genetik dan pembagian manfaatnya |
| Hukum lunak | Pedoman yang tidak mengikat secara hukum tetapi berpengaruh pada praktik |
| Metadata | Data tentang data, misalnya arti kolom, satuan, dan cara pengumpulan |
| Data rapi | Tabel dengan satu variabel per kolom dan satu pengamatan per baris |
| DOI | Kode pengenal digital permanen untuk artikel atau dataset |
Daftar Pustaka
Bik, E. M., Casadevall, A., & Fang, F. C. (2016). The prevalence of inappropriate image duplication in biomedical research publications. mBio, 7(3), e00809-16. https://doi.org/10.1128/mBio.00809-16
Clark, T. D., Raby, G. D., Roche, D. G., Binning, S. A., Speers-Roesch, B., Jutfelt, F., & Sundin, J. (2020). Ocean acidification does not impair the behaviour of coral reef fishes. Nature, 577, 370–375. https://doi.org/10.1038/s41586-019-1903-y
Fanelli, D. (2009). How many scientists fabricate and falsify research? A systematic review and meta-analysis of survey data. PLoS ONE, 4(5), e5738. https://doi.org/10.1371/journal.pone.0005738
Jobin, A., Ienca, M., & Vayena, E. (2019). The global landscape of AI ethics guidelines. Nature Machine Intelligence, 1(9), 389–399. https://doi.org/10.1038/s42256-019-0088-2
Lindenmayer, D., & Scheele, B. (2017). Do not publish. Science, 356(6340), 800–801. https://doi.org/10.1126/science.aan1362
Nosek, B. A., Alter, G., Banks, G. C., Borsboom, D., Bowman, S. D., Breckler, S. J., Buck, S., Chambers, C. D., Chin, G., Christensen, G., Contestabile, M., Dafoe, A., Eich, E., Freese, J., Glennerster, R., Goroff, D., Green, D. P., Hesse, B., Humphreys, M., … Yarkoni, T. (2015). Promoting an open research culture. Science, 348(6242), 1422–1425. https://doi.org/10.1126/science.aab2374
Pennisi, E. (2020). Prominent spider biologist spun a web of questionable data. Science, 367(6478), 613–614. https://doi.org/10.1126/science.367.6478.613
Prathapan, K. D., Pethiyagoda, R., Bawa, K. S., Raven, P. H., Rajan, P. D., & 172 co-signatories from 35 countries. (2018). When the cure kills: CBD limits biodiversity research. Science, 360(6396), 1405–1406. https://doi.org/10.1126/science.aat9844
Roche, D. G., Kruuk, L. E. B., Lanfear, R., & Binning, S. A. (2015). Public data archiving in ecology and evolution: How well are we doing? PLoS Biology, 13(11), e1002295. https://doi.org/10.1371/journal.pbio.1002295
Vines, T. H., Albert, A. Y. K., Andrew, R. L., Débarre, F., Bock, D. G., Franklin, M. T., Gilbert, K. J., Moore, J.-S., Renaut, S., & Rennison, D. J. (2014). The availability of research data declines rapidly with article age. Current Biology, 24(1), 94–97. https://doi.org/10.1016/j.cub.2013.11.014
Walters, W. H., & Wilder, E. I. (2023). Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13, 14045. https://doi.org/10.1038/s41598-023-41032-5
Wilson, G., Bryan, J., Cranston, K., Kitzes, J., Nederbragt, L., & Teal, T. K. (2017). Good enough practices in scientific computing. PLoS Computational Biology, 13(6), e1005510. https://doi.org/10.1371/journal.pcbi.1005510
Catatan: judul asli artikel Prathapan dkk. (2018) memakai tanda pisah panjang; di sini ditulis dengan titik dua mengikuti ketentuan gaya modul.
Selamat Datang di Pertemuan 10
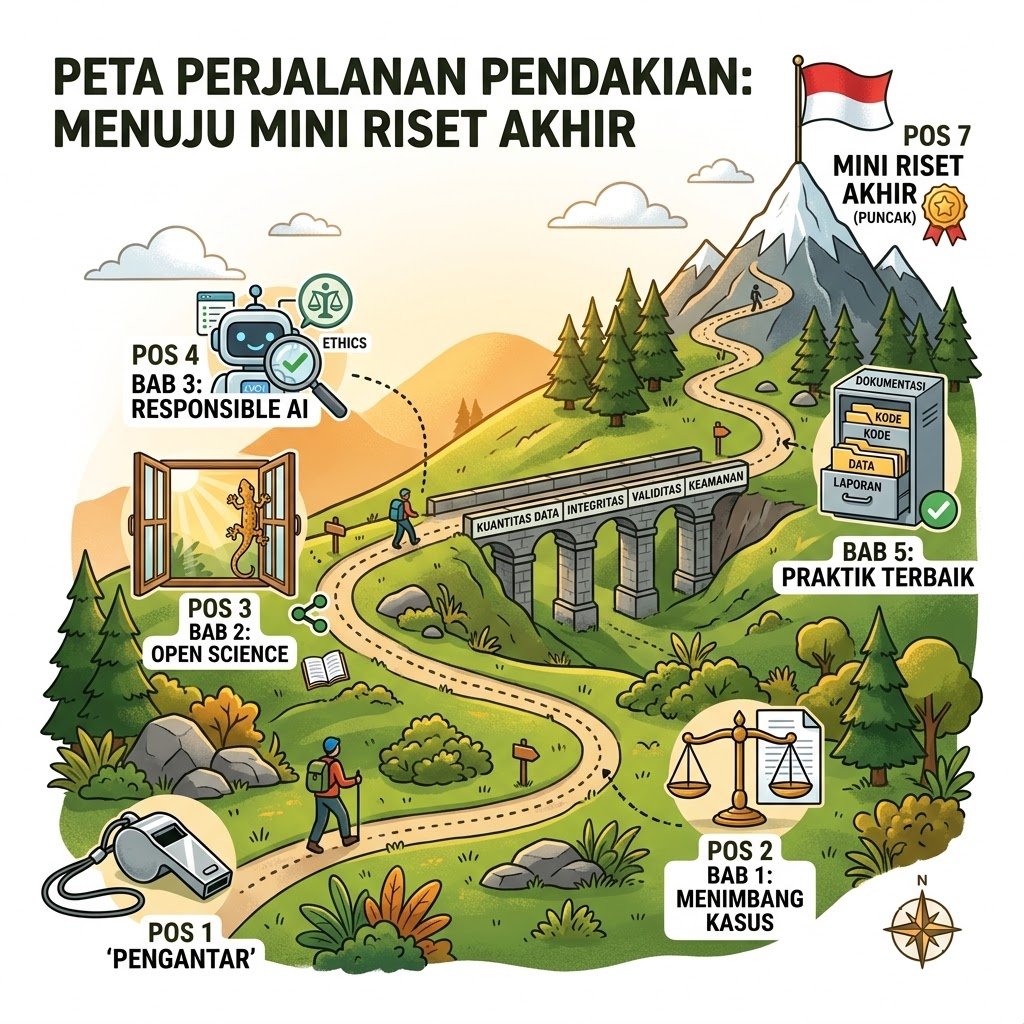
Selamat datang di pertemuan kesepuluh. Di pertemuan sebelumnya, Anda sudah berkenalan dengan aturan main: etika digital, hak cipta, privasi, prinsip FAIR, dan Data Management Plan. Sekarang saatnya naik satu tingkat, dari orang yang tahu aturan menjadi orang yang sanggup menilai apakah aturan itu benar-benar dijalankan. Modul ini disusun seperti ruang sidang kecil, tempat Anda akan membaca kasus nyata, menimbang bukti, lalu mengambil keputusan yang bisa dipertanggungjawabkan. Bacalah bab demi bab secara berurutan, karena setiap bab menyiapkan alat yang dipakai di bab berikutnya.
| Identitas Modul | |
|---|---|
| Mata kuliah | Teknologi Informasi dan Literasi Data (TILDA), 2 SKS, Semester 3 |
| Pertemuan | Ke-10 |
| CPL 4 | Merancang penelitian biologi menggunakan pendekatan ilmiah dari tingkat molekuler hingga ekosistem. |
| CPMK 3 | Merancang pemanfaatan teknologi informasi dan literasi data untuk mendukung penyusunan rancangan penelitian biologi berdasarkan pendekatan ilmiah dan kaidah etika akademik. |
| Sub-CPMK 5 | Mengevaluasi validitas, reliabilitas, keamanan, dan etika penggunaan data serta informasi digital dalam penelitian biologi. |
| Indikator | Mengevaluasi penerapan etika dan keamanan data pada studi kasus penelitian biologi. |
| Metode | Case Method, Problem-Based Learning, diskusi kelompok, presentasi, peer review |
| Nilai karakter | Kejujuran, tanggung jawab, kepedulian, etika berkomunikasi, kerja sama |
| Tagihan | Mini Riset Akhir (kelompok) |
| Bobot penilaian | 4% dari nilai akhir mata kuliah |
| Alokasi waktu | Tatap muka 2 × 50 menit; tugas terstruktur 2 × 60 menit; belajar mandiri 2 × 60 menit |
Setelah mempelajari modul ini, Anda mampu:
- Membedakan kekeliruan jujur, praktik penelitian meragukan, dan pemalsuan data berdasarkan bukti.
- Mengevaluasi kasus etika penelitian biologi dengan kerangka FAKTA.
- Menimbang manfaat dan risiko keterbukaan data, termasuk data lokasi spesies dan sumber daya genetik.
- Menilai penggunaan AI generatif dalam penelitian berdasarkan prinsip tata kelola AI.
- Menguji data dari sisi validitas, reliabilitas, keamanan, dan keberlanjutan.
- Memberikan peer review yang konstruktif terhadap DMP kelompok lain.
Cara Memakai E-Modul Ini
Gunakan menu di bagian atas untuk berpindah bab, atau tombol di bagian bawah setiap halaman untuk melanjutkan. Kotak berwarna punya fungsi berbeda: kotak hijau berisi poin penting, kotak amber berisi tips, kotak bergaris putus-putus berisi studi kasus, dan kotak ungu berisi pertanyaan reflektif. Setiap bab ditutup dengan jeda singkat untuk merenung, dan semuanya berujung di Pojok Refleksi. Tugas kelompok untuk Mini Riset Akhir ada di menu Aktivitas dan Tugas, lengkap dengan rubrik peer review.
1.Kasus yg paling mengusik saya adalah dari kasus 3.1 ketika mesin mengarang daftar pustaka.Karena kalo dipikir-pikir AI itu juga nggak selalu benar ,AI bisa memanipulasi data,mencopy data lain,hingga membuat data seolah-olah benar.Dan lebih baik dalam membuat daftar pustaka itu kita lakukan sendiri tanpa bantuan dari AI,dan dampaknya juga lebih baik dalam membantu otak kita bekerja.
2.Tinjauan teoritis dan daftar pustakanya,karena bagian yg kedua itu sangat penting dan sering kali salah dalam menukiskannya,jadi harus disiapkan terdahulu.
3.Kemarin.Dan biasanya saya tidak terlalu mencantumkan penuh hasil AI kedalam tugas,kuta harus membaca dan memamhami jawaban AI nya dulu,karena AI tidak selalu benar.
4.Kebiasaan yg harus dipeetahankan adalah menyimpan data dengan rapi dan bila perlu mencadangkan atau backup data.